BlogPerspectivas del sector
Diferencia entre LLM y orquestador: por qué es importante para los sistemas de IA reales
Equipo BridgeApp
Lectura de 15 min
Si está construyendo algo más allá de un prototipo de chatbot, probablemente se haya topado con esta pregunta: ¿dónde termina el trabajo del modelo y dónde comienza el sistema que lo rodea? Este artículo desglosa la diferencia práctica entre los modelos de lenguaje grandes y los orquestadores, por qué importa la distinción y cómo trabajan juntos en la IA de producción.
Puntos clave
- Un modelo de lenguaje grande (LLM) es el motor predictivo que genera texto, razona sobre instrucciones y produce resultados. Un orquestador es la capa de control que gestiona flujos de trabajo, herramientas, datos y múltiples modelos a su alrededor. Son componentes arquitectónicos fundamentalmente diferentes.
- Las aplicaciones modernas de IA —desde chatbots y agentes de IA hasta herramientas para desarrolladores— necesitan ambos: LLM para el razonamiento y la generación, orquestación para la fiabilidad, la gobernanza y la integración perfecta con sistemas reales.
- La orquestación de LLM cubre el enrutamiento inteligente, la llamada a herramientas, la gestión de contextos, el historial de conversaciones y la observabilidad en proveedores como OpenAI, Anthropic, DeepSeek y otros.
- Confundir un LLM con un sistema de IA completo lleva a prototipos frágiles que fallan en producción. Comprender dónde terminan las capacidades de LLM y comienza la orquestación es el primer paso hacia la construcción de aplicaciones de IA mantenibles.
- Plataformas como BridgeApp utilizan un motor de orquestación diseñado específicamente para convertir las capacidades brutas de los LLM en sistemas de IA gobernados y de grado de producción, particularmente para pipelines de automatización de desarrollo.
1. Introducción: Por qué "LLM vs. orquestador" es una verdadera pregunta arquitectónica
Imagine un escenario cada vez más común en 2025–2026: un equipo de ingeniería construyó una prueba de concepto utilizando una única API de LLM. Funcionó bien en las demostraciones. Ahora, la dirección quiere que funcione en producción: gestionando datos de clientes, llamando a APIs internas, cambiando entre múltiples modelos de IA en función del costo y la latencia, registrando cada acción para el cumplimiento y recuperándose elegantemente cuando un proveedor falla.
El equipo se da cuenta rápidamente de que "llamar a la API de OpenAI" y "tener un sistema de IA" no son lo mismo.
Esta confusión está en el centro de la pregunta LLM vs. orquestador. Así es como hay que pensar en ello:
- LLM / modelo de lenguaje grande = un modelo probabilístico que predice texto. Genera, razona y resume, pero no gestiona flujos de trabajo, no accede a su base de datos ni conoce sus reglas de negocio.
- Orquestador / capa de orquestación = el sistema de coordinación y control alrededor de uno o muchos modelos. Decide qué llamar, cuándo, con qué contexto y qué hacer con el resultado.
El resto de este artículo:
- Comparará los roles y responsabilidades de cada componente.
- Mostrará cómo trabajan juntos en aplicaciones impulsadas por LLM.
- Proporcionará orientación sobre cuándo invertir en herramientas de orquestación.
El enfoque aquí es la ingeniería práctica para aplicaciones de IA, no la investigación de modelos.
2. ¿Qué es un LLM (modelo de lenguaje grande)?
Un modelo de lenguaje grande es una red neuronal entrenada en vastos corpus de texto para predecir el siguiente token. Si ha usado GPT-4o, Claude 3.5 Sonnet, Gemini 1.5 Pro o Llama 3.1, ha interactuado con un LLM. Estos son los motores de razonamiento centrales detrás de la mayoría de las aplicaciones de IA generativa actuales.
Capacidades principales de los modelos de lenguaje grandes (LLM):
- Comprensión y generación de lenguaje natural: desde la capacidad de resumir hasta la escritura creativa y la producción de código.
- Razonamiento sobre instrucciones, código y documentos cuando se le dan los prompts apropiados.
- Uso limitado de herramientas cuando se envuelve en código externo o protocolos (por ejemplo, especificaciones de llamada a funciones).
Limitaciones intrínsecas que importan para el diseño del sistema:
- Sin lógica de negocio, programación o estado de flujo de trabajo incorporados. Un LLM no "sabe" que es el paso 3 de un pipeline de 7 pasos.
- Ventana de contexto fija y fecha de corte de conocimiento (típicamente 2024–2025 para los modelos actuales). La información más allá de ese límite es invisible a menos que se inyecte.
- Sin acceso directo a bases de datos, APIs o su infraestructura sin una capa externa que medie la conexión.
En la mayoría de los sistemas de IA de producción, no hay un único modelo LLM que lo impulse todo. Los equipos utilizan múltiples instancias de LLM —diferentes proveedores, tamaños y ajustes— seleccionando el adecuado para cada tarea. Un modelo ligero maneja la clasificación; uno de alta capacidad maneja el razonamiento complejo; un ajuste especializado maneja la generación específica de un dominio. ¿Esa lógica de selección? No es parte del LLM en sí. Pertenece al orquestador.
3. ¿Qué es un orquestador en sistemas de IA?
Un orquestador —o capa de orquestación— es el componente del sistema que:
- Gestiona flujos de trabajo que involucran uno o más LLM, herramientas y fuentes de datos.
- Decide qué modelo llamar, con qué prompt y contexto, y qué hacer con el resultado.
Como lo expresan los profesionales de IBM, "la orquestación de LLM ayuda a hacer prompts, encadenar, gestionar y monitorear modelos de lenguaje grandes… facilitando el acceso y la recuperación de datos… gestionando prompts, interacción con la API, recuperación de datos y gestión de estados en las conversaciones."
Responsabilidades típicas de un orquestador:
- Gestión de flujos de trabajo y estados (flujos multiagente con ramificación y dependencias).
- Enrutamiento inteligente entre modelos y herramientas, incluyendo el equilibrio de carga y la optimización de costos.
- Manejo de errores, reintentos, limitación de velocidad, conmutación por error y registro en todos los proveedores de LLM.
- Gestión de contexto y persistencia de memoria entre sesiones y agentes.
- Gobernanza empresarial: políticas, permisos, registros de auditoría y aplicación de cumplimiento.
En 2026, esto se implementa típicamente a través de:
- Frameworks de orquestación (por ejemplo, LangChain, LlamaIndex, Semantic Kernel).
- Pasarelas de IA y plataformas de orquestación (enrutadores multiproveedor con observabilidad).
- Motores de orquestación personalizados incrustados en plataformas como BridgeApp, que envuelven estas capacidades en un sistema opinionado y listo para producción para la automatización del desarrollo.
La distinción crítica: el orquestador no es un modelo. Es una capa arquitectónica —código más tiempo de ejecución— que utiliza modelos de lenguaje como componentes. No genera texto. Gestiona todo lo que rodea la generación.
4. Diferencia clave: "Cerebro" vs. "Plano de control"
La forma más sencilla de entender la diferencia: un LLM es el "cerebro" estadístico que responde preguntas y genera contenido. Un orquestador es el "plano de control" que decide cuándo, cómo y bajo qué restricciones usar ese cerebro dentro de un sistema de IA más grande.
Piénselo de esta manera:
- El LLM es un consultor altamente cualificado que puede leer, escribir y razonar, pero no tiene calendario, sistema de gestión de proyectos, acceso a sus bases de datos internas ni memoria de la reunión de la semana pasada.
- El orquestador es el gerente de proyecto más el motor de flujo de trabajo: asigna tareas, establece el orden, valida los resultados e integra los resultados con los sistemas de la empresa.
Diferencias explícitas dimensión por dimensión:
- Enfoque: Predicción y generación de texto vs. gestión del flujo de tareas y datos a través de procesos complejos.
- Alcance: Un solo turno o hilo de conversación vs. todo un proceso de negocio de varios pasos que puede durar horas o días.
- Entradas/salidas: Prompts y tokens (entradas y salidas de LLM) vs. eventos, trabajos, llamadas a API y cargas útiles estructuradas.
- Responsabilidad: Corrección de una sola respuesta (calidad de salida) vs. fiabilidad, auditabilidad y costo en muchas llamadas a LLM.
- Estado: Sin estado entre llamadas a la API (el LLM olvida) vs. gestión de estado persistente (el orquestador recuerda y rastrea).
- Gobernanza: Sin políticas innatas (el LLM hace lo que dice el prompt) vs. control centralizado sobre permisos, acceso a herramientas y cumplimiento.
Ambos son necesarios. La IA de producción depende de una sólida capa de modelo y una capa de orquestación disciplinada que trabajen juntas.
5. Dónde terminan los LLM y dónde empiezan los orquestadores: división de responsabilidades
Trazar una línea clara entre lo que pertenece al "trabajo" del LLM y lo que maneja el orquestador evita la confusión arquitectónica y los sistemas frágiles.
Lo que vive en el lado del LLM:
- Razonamiento en lenguaje natural, resumen, generación de contenido: las capacidades centrales del LLM.
- Toma de decisiones local cuando el orquestador proporciona restricciones y herramientas claras (por ejemplo, elegir la función correcta para llamar según la pregunta de un usuario).
- Producción de salidas estructuradas, redacción de código, traducción entre idiomas o formatos.
Lo que pertenece al orquestador:
- Estado de larga duración (por ejemplo, un flujo de trabajo de incorporación de una semana o un sprint de desarrollo de varios días con un historial de conversación persistente).
- Gestión de datos: recuperación de bases de datos vectoriales, almacenes SQL, APIs e inyección de datos contextuales en los prompts.
- Programación, reintentos, retroceso y gestión de límites de velocidad en múltiples proveedores de LLM.
- Decisiones de enrutamiento de modelos: qué proveedor, qué tamaño de modelo, qué región.
- Aplicación de la gobernanza: quién puede acceder a qué herramientas, qué se registra, cuándo los humanos deben aprobar.
Escenarios concretos que ilustran la división:
- Asistente de atención al cliente: Una solicitud de usuario activa al orquestador para recuperar datos de pedidos de un CRM (a través de API), obtener documentos relevantes de una base de conocimientos (base de datos vectorial) y luego llamar a un LLM para redactar una respuesta. Si el sentimiento del cliente es de enojo, el orquestador escala a un agente humano. El LLM produce el borrador; el orquestador conecta todos los pasos, maneja la lógica de escalada y registra la interacción.
- Pipeline de automatización de desarrollo: Llega una tarea ("agregar característica X"). El orquestador utiliza un agente de planificación para diseñar el enfoque, un agente de código para implementar, un agente de revisión de código para evaluar, y luego se integra con el repositorio de código y el pipeline de CI. Los LLM impulsan el razonamiento de cada agente; el orquestador impulsa el flujo, las dependencias y las transiciones de estado.
Intentar empujar las responsabilidades de orquestación a la pura ingeniería de prompts se convierte rápidamente en lo que los equipos experimentados llaman "spaghetti de prompts": cadenas frágiles de instrucciones que se rompen de forma impredecible a medida que crece la complejidad.
6. Orquestación de LLM en la práctica: tareas que maneja el orquestador
Aquí está lo que la buena orquestación de LLM realmente hace en una pila real: una lista de verificación concisa de las responsabilidades que gestiona la orquestación:
Encadenamiento de prompts y llamadas a LLM de varios pasos:
- Vinculación de múltiples llamadas a LLM preservando el contexto y los resultados intermedios. La salida de un modelo se convierte en la entrada de otro, con plantillas de prompts y ejemplos de few-shot gestionados por el orquestador.
- Manejo de la lógica de ramificación: si la primera llamada clasifica una solicitud como "facturación", se enruta a prompts específicos de facturación; si es "técnica", se enruta a una cadena diferente.
Integración de LLM en todos los proveedores:
- Interfaces estándar para múltiples proveedores y modelos de LLM (OpenAI, Anthropic, Mistral, modelos locales). Una interfaz unificada significa que cambiar o agregar proveedores no requiere reescribir la lógica de la aplicación.
- Compatibilidad con múltiples instancias de LLM simultáneamente para pruebas A/B o procesamiento paralelo de solicitudes concurrentes.
Gestión de datos y generación aumentada de recuperación:
- Recuperación y preparación de contexto a través de RAG: consultas a bases de datos vectoriales y almacenes de documentos, luego limpieza y estructuración de cargas útiles antes de que lleguen al modelo.
- Preprocesamiento de datos: filtrado, fragmentación y reclasificación de documentos recuperados para que el LLM reciba solo datos contextuales relevantes.
Enrutamiento inteligente:
- Envío de tareas simples a modelos más baratos y rápidos, y tareas de razonamiento complejas a modelos de gama alta, optimizando la utilización de recursos y controlando los costos.
- Conmutación por error automática cuando un proveedor está inactivo o limitado por velocidad, con interruptores de circuito y equilibrio de carga.
Manejo de memoria:
- El orquestador gestiona el historial de conversaciones más allá de la ventana de contexto del modelo, comprimiendo o resumiendo turnos anteriores.
- Memoria a largo plazo externalizada para agentes de IA entre sesiones, para que un agente "recuerde" interacciones pasadas sin introducir todo en el prompt.
Los frameworks de orquestación de LLM como LangChain o LlamaIndex ofrecen bloques de construcción para estas tareas. Plataformas como BridgeApp agrupan capacidades similares en un motor opinionado, manejando la orquestación, el enrutamiento de modelos y la gobernanza en un sistema unificado en lugar de requerir que los equipos ensamblen piezas.
7. LLM vs. Orquestador en configuraciones multiagente y de agente de IA
Los sistemas multiagente son uno de los patrones definitorios de la arquitectura de IA de 2025–2026. En lugar de un solo prompt monolítico, diferentes agentes basados en roles —investigador, codificador, revisor, planificador— colaboran en tareas complejas. Aquí es donde la diferencia entre LLM y orquestador se vuelve más visible.
Cómo se dividen los roles en configuraciones multiagente:
- Cada agente de IA suele estar impulsado por uno o más LLM (el núcleo de razonamiento). La "inteligencia" del agente proviene del modelo de lenguaje.
- El orquestador coordina a los agentes: asignación de tareas, orden de dependencia, tiempos de espera, resolución de conflictos y memoria compartida. La "fiabilidad" del agente proviene de la orquestación.
Un pipeline de agente típico se ve así:
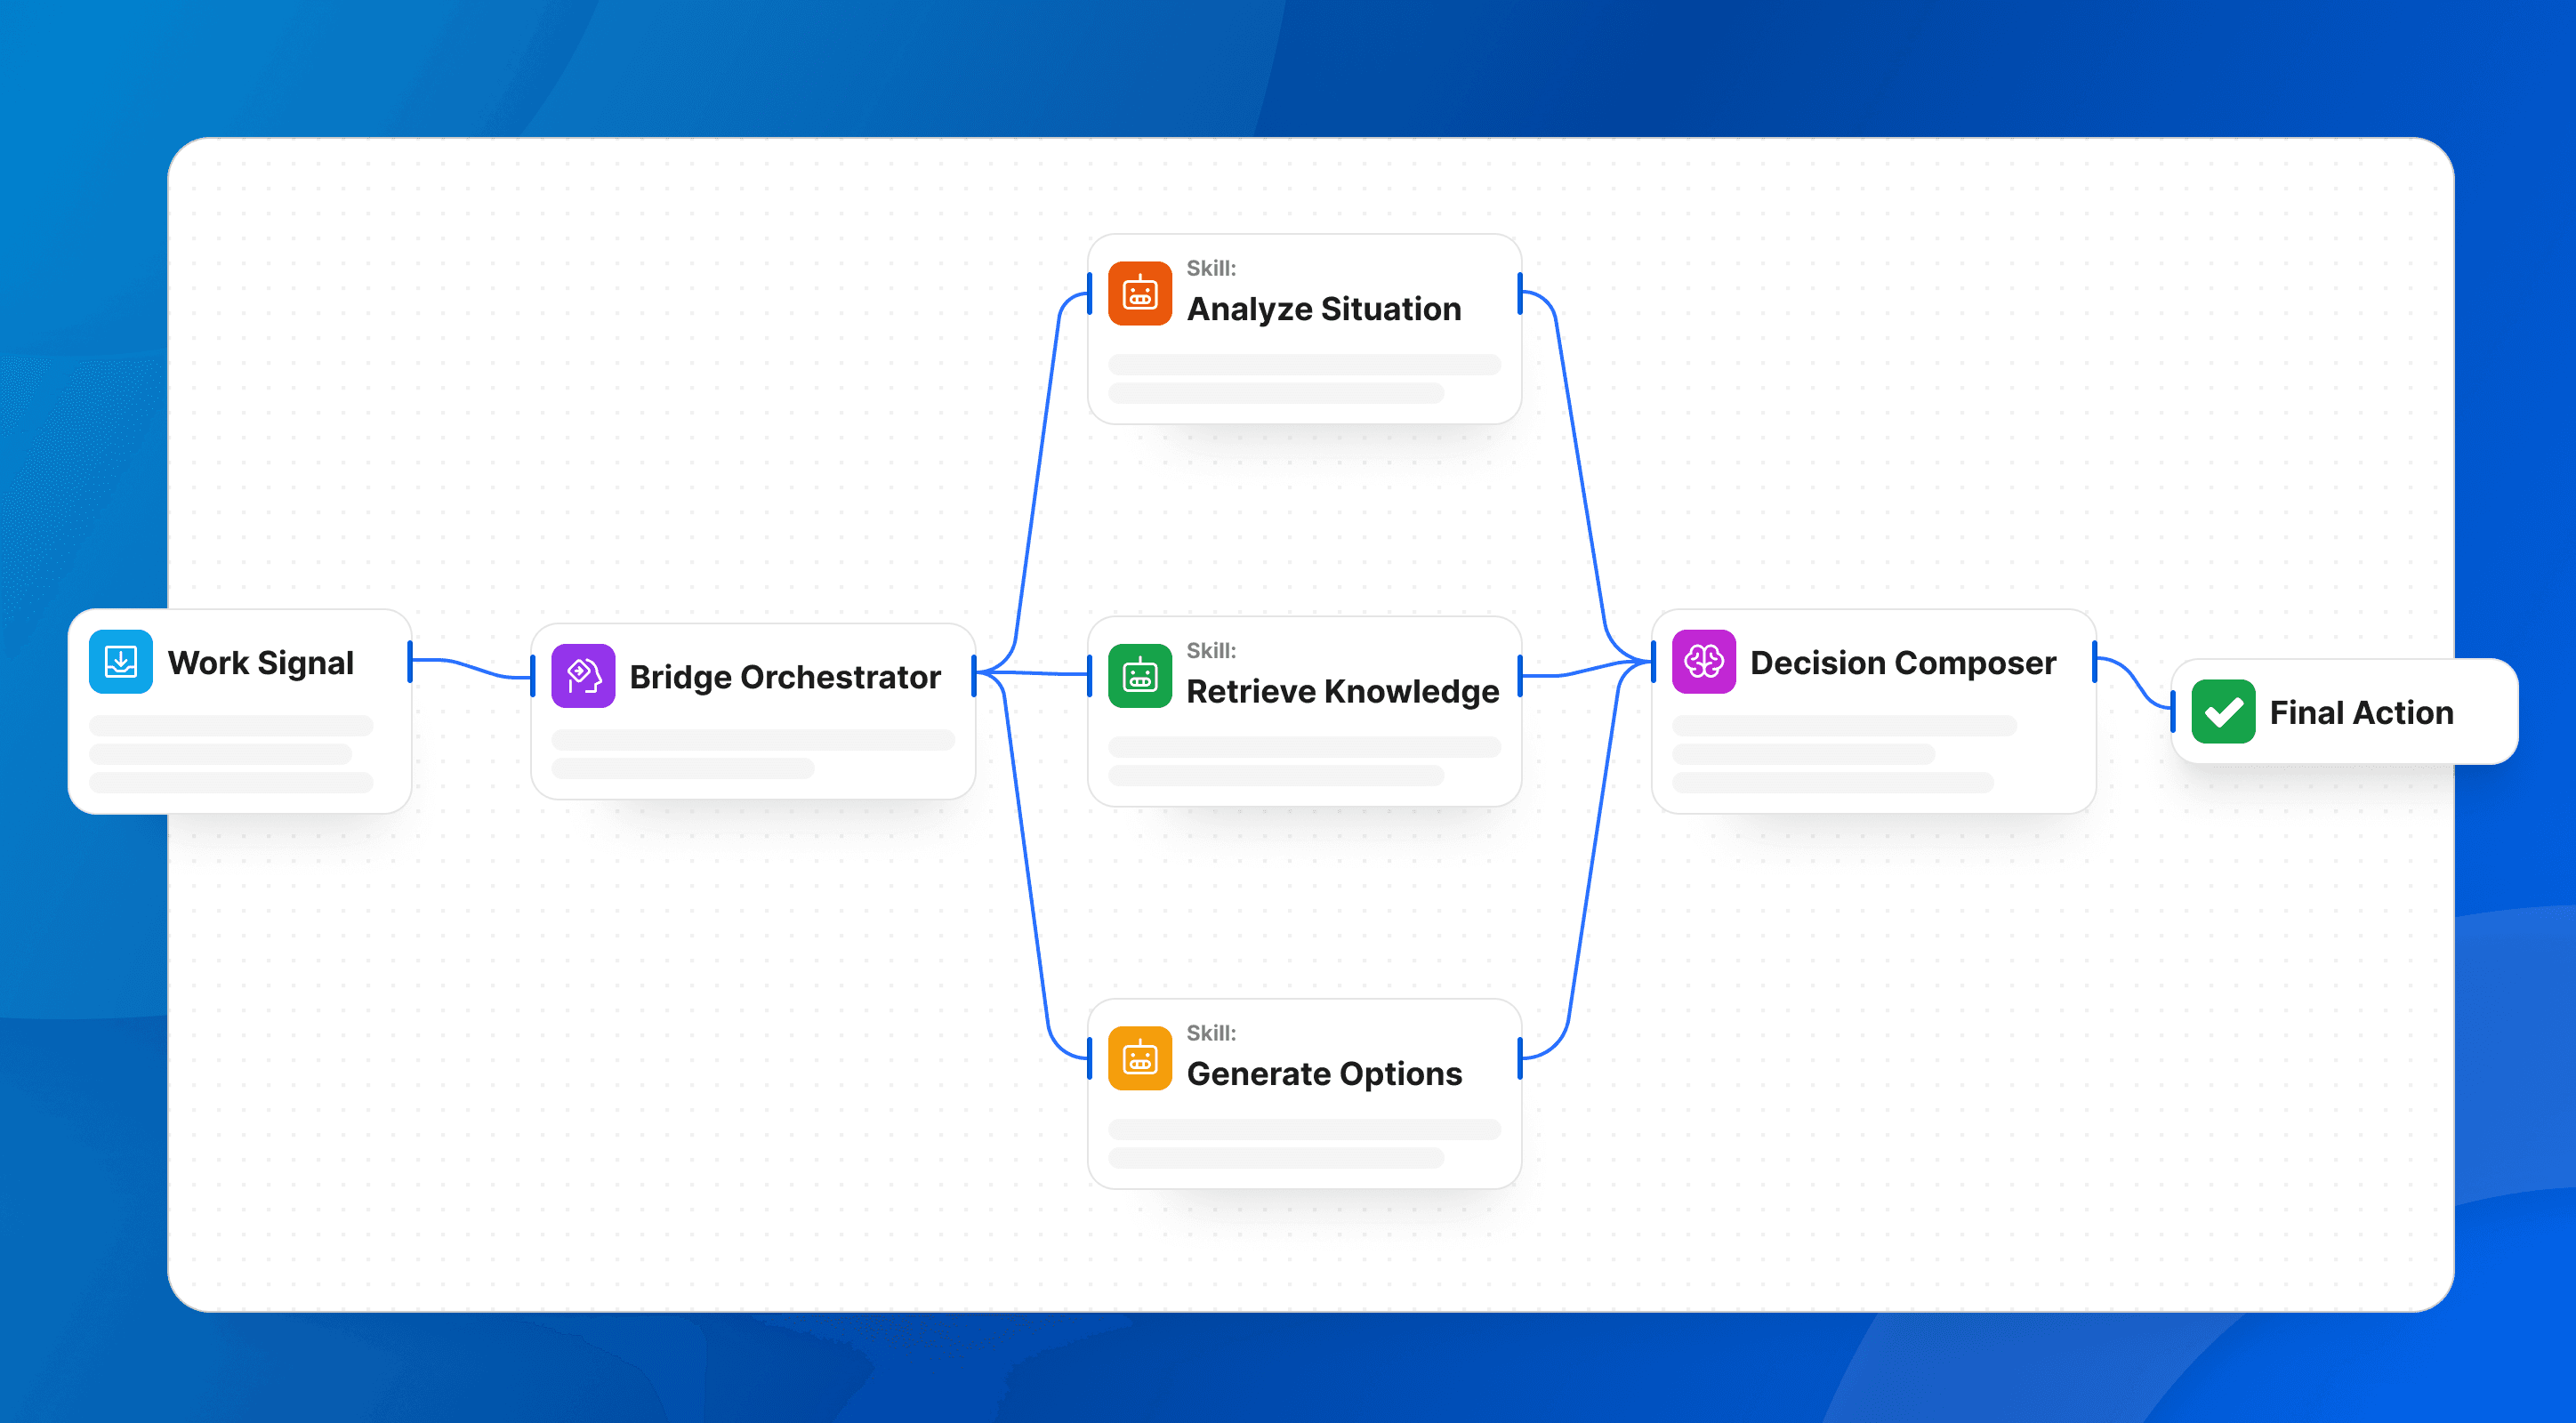
Agente de investigación → agente de planificación → agente de ejecución → agente de control de calidad, todos coordinados por una capa de orquestación que gestiona las transferencias, rastrea el estado y aplica las reglas.
Por qué la orquestación es crítica para múltiples agentes de IA:
- Evitar interbloqueos: agentes que esperan el uno al otro en dependencias circulares.
- Hacer cumplir los límites de presupuesto, uso de tokens y tiempo. Sin esto, los bucles de agentes pueden consumir recursos sin fin.
- Mantener una única fuente de verdad compartida para el contexto y la memoria, para que los agentes no se contradigan ni repitan el trabajo.
- Manejar la ejecución paralela donde sea seguro y serializar donde el orden importa.
Magic Coder de BridgeApp utiliza exactamente este patrón: un pipeline multiagente con agentes de líder de equipo, arquitecto de sistemas, desarrollador, revisor de código y control de calidad, todos gestionados por un motor de orquestación. El pipeline aplica bucles de revisión (revisión de plan, revisión de código local) y se detiene en "Esperando fusión" por diseño, para que los humanos aprueben los cambios finales. Los LLM realizan el razonamiento; el orquestador asegura que el proceso sea controlado y mantenible.
8. Orquestación de LLM para datos y contexto: RAG, memoria y "Verdad"
Los modelos de lenguaje grandes no "conocen" intrínsecamente sus datos privados, ni mantienen una memoria a largo plazo entre llamadas. Cada llamada comienza de nuevo a menos que algo externo proporcione continuidad. Aquí es donde la recuperación de datos y la gestión de contexto se convierten en preocupaciones centrales de la orquestación.
La Generación Aumentada por Recuperación (RAG) es el patrón dominante para fundamentar las respuestas de LLM en datos reales. El orquestador consulta fuentes de conocimiento —una base de datos vectorial, un almacén SQL o una API— recupera documentos relevantes y los inyecta en el prompt antes de que el LLM genere una respuesta. El modelo en sí no "busca"; la capa de orquestación maneja la búsqueda web, las consultas a bases de datos y el preprocesamiento de datos.
Cómo el orquestador gestiona el contexto para aplicaciones LLM aumentadas por contexto:
- Selección de qué documentos o hechos incluir en función de la puntuación de relevancia y el control de acceso.
- Compresión y resumen del historial para ajustarse a los límites de tokens, de modo que el modelo obtenga la máxima señal con el mínimo de tokens.
- Aplicación de reranking o filtros para mantener el contexto relevante y evitar alucinaciones por datos irrelevantes.
Verificación de la salida como responsabilidad de la orquestación:
- Verificación cruzada de las respuestas de LLM con bases de conocimiento antes de entregarlas a los usuarios.
- Ejecución de un modelo "crítico" o evaluador separado para salidas arriesgadas, un patrón en el que el orquestador llama a un segundo modelo LLM específicamente para el control de calidad.
Nada de esto lo hace el LLM por sí solo. La gestión de datos, la ingeniería de contexto y la verificación de hechos son tareas de orquestación, partes fundamentales de la construcción de aplicaciones LLM sofisticadas en las que los usuarios pueden confiar.
9. Fiabilidad, seguridad y gobernanza: por qué la orquestación es imprescindible
Las llamadas LLM puras no pueden resolver por sí solas varias preocupaciones de fiabilidad:
- Las interrupciones de los proveedores, los límites de velocidad y los errores transitorios de la red son hechos de la vida cuando se trabaja con puntos finales de la API de LLM externos.
- Las salidas no deterministas de los LLM conducen a un comportamiento inconsistente entre ejecuciones: el mismo prompt puede producir resultados diferentes.
Cómo el orquestador aborda la fiabilidad:
- Los reintentos con retroceso, los interruptores de circuito y las colas aseguran que un único problema del proveedor no bloquee el flujo de trabajo.
- El almacenamiento en caché semántico y la idempotencia para flujos de trabajo de larga duración evitan el trabajo duplicado y reducen los costos.
- Monitoreo y seguimiento del rendimiento entre proveedores, con métricas clave como latencia, tasas de error y métricas de rendimiento para la economía de tokens.
Seguridad y gobernanza empresarial:
- Políticas centrales para qué modelos y herramientas pueden acceder a qué datos. La orquestación gestiona los permisos de las herramientas a un nivel granular.
- Registros de auditoría de prompts, respuestas de LLM y llamadas a herramientas para el cumplimiento, esenciales en industrias reguladas como finanzas y atención médica.
- Entornos de ejecución en sandbox que aíslan el código impulsado por LLM de la infraestructura de producción.
Aquí es donde las plataformas de orquestación serias difieren de "simplemente llamar a la API". BridgeApp, por ejemplo, ejecuta automatizaciones impulsadas por LLM dentro de sandboxes de microVM aislados, aplica reglas de permisos en capas a cada herramienta a la que un agente puede acceder y registra cada paso para la revisión humana. Los secretos se cifran en reposo, las credenciales de Git son de corta duración y tienen alcance, y cada mutación de autenticación se audita, el tipo de gobernanza que las interacciones de modelos puros simplemente no pueden proporcionar.
10. Cómo BridgeApp utiliza la orquestación para convertir los LLM en una verdadera automatización del desarrollo
Para anclar estos conceptos en una plataforma de aplicaciones impulsadas por LLM del mundo real, considere cómo BridgeApp y Magic Coder de BridgeApp implementan la arquitectura LLM + orquestador para el ciclo de vida de desarrollo de software (SDLC).
El pipeline de desarrollo multiagente dentro de BridgeApp:
- Agente líder de equipo: admisión, triaje y orquestación de tareas; asigna trabajo y aprueba planes.
- Agente arquitecto de sistemas: inspecciona el código y los requisitos; redacta el plan de implementación.
- Agentes desarrolladores (backend / UI): implementan planes aprobados, escriben pruebas y documentos, abren PRs.
- Agentes de revisión de código y QA: evalúan el código según el plan, detectan problemas antes de la fusión.
Qué maneja el motor de orquestación:
- Transiciones de estado: Tarea pendiente → Planificación → Revisión de plan → Ejecución → Revisión de código local → Esperando fusión. Cada estado tiene condiciones de entrada/salida claras, y los agentes nunca avanzan una tarea a "Hecho"; el pipeline se detiene en "Esperando fusión" para que los humanos revisen la salida final.
- Paralelización del trabajo entre múltiples agentes de IA donde sea seguro, y reanudación desde el último punto de control después de fallas.
Conexión con conceptos anteriores:
- Enrutamiento inteligente entre diferentes proveedores de LLM a través de una capa de modelo unificada (OpenAI, Anthropic, DeepSeek y otros): el orquestador elige el modelo correcto para la tarea de cada agente.
- Gestión de datos utilizando bases de conocimiento y gráficos de bases de código (análisis global del código de los llamadores, cadenas de llamadas, rastreos entre servicios) para dar a cada agente los datos contextuales correctos.
- Gobernanza con habilidades, reglas y ejecución en sandbox explícitas: cada agente opera dentro de límites definidos.
El objetivo aquí no es un argumento de venta. Es mostrar que la distinción abstracta entre LLM y orquestador se aplica directamente a cómo se construyen los sistemas reales: los modelos razonan, y el orquestador se asegura de que ese razonamiento ocurra de manera confiable dentro de un pipeline controlado y auditable.
11. ¿Cuándo necesita un orquestador vs. "simplemente un LLM"?
No todos los casos de uso de IA necesitan una plataforma de orquestación completa. Aquí es donde una sola llamada a la API de LLM es suficiente:
- Generación de contenido puntual: redactar una entrada de blog, resumir un documento.
- Preguntas y respuestas simples sobre el conocimiento web público: sin datos privados, sin lógica de varios pasos.
- Prototipos o experimentos internos donde la velocidad es más importante que la fiabilidad.
Contraste eso con situaciones en las que la orquestación de IA se vuelve innegociable:
- Múltiples modelos, proveedores o regiones con requisitos de optimización de costos.
- Flujos de trabajo de LLM de varios pasos con herramientas, bases de datos y sistemas externos.
- Necesidad de observabilidad, SLA y gobernanza a nivel de equipo: seguimiento del rendimiento, registros de auditoría, controles de costos.
- Escenarios que involucran múltiples agentes de IA que se coordinan en tareas complejas.
Una lista de verificación simple para los líderes de ingeniería:
- ¿Necesita llamar a más de una herramienta o modelo? → Considere la orquestación.
- ¿Necesita registros de auditoría, seguimiento de costos y enrutamiento de modelos? → Necesita un orquestador.
- ¿Los equipos no técnicos dependerán de este sistema de IA para los procesos comerciales centrales? → Invierta en orquestación desde el principio.
Un artículo de investigación de 2026 que evalúa la orquestación de LLM encontró que la orquestación mejoró la precisión en aproximadamente 4 a 5 puntos porcentuales sobre las líneas de base optimizadas de cadena de pensamiento, pero vino con aproximadamente 2 a 4 veces el costo de los tokens. La compensación es real, y vale la pena hacerla deliberadamente en lugar de descubrirla después de que su prototipo llegue a producción.
Si está construyendo un sistema importante, piense en "LLM + orquestador" desde el principio en lugar de agregar la orquestación después de que las cosas se rompan.
12. Resumen: LLM, orquestadores y el futuro de las aplicaciones de IA
- Los LLM son los motores de razonamiento y generación: producen la inteligencia.
- Los orquestadores son las capas de ejecución, enrutamiento y gobernanza: producen la fiabilidad.
- Los sistemas de IA escalables y los agentes de IA requieren que ambos trabajen juntos, cada uno haciendo lo que mejor sabe.
La orquestación de LLM es ahora tan fundamental como el propio modelo para la IA de producción. En las arquitecturas multi-modelo y multi-agente de 2025–2026, la capa de orquestación es lo que separa una demostración de un producto. Plataformas como BridgeApp combinan la integración de LLM, la orquestación y las mejores prácticas de automatización del desarrollo para que los equipos puedan ir más allá de los prototipos hacia pipelines SDLC fiables impulsados por IA, con capacidades de equipo que escalan a medida que la organización crece.
Eche un vistazo a su arquitectura actual. ¿Dónde las llamadas LLM puras están haciendo un "trabajo de orquestación oculto" enterrado en código o prompts? ¿Dónde una capa de orquestación dedicada —ya sean frameworks de orquestación de código abierto, una plataforma de orquestación gestionada o un motor construido a propósito— podría simplificar, endurecer y hacer su sistema observable? Esa es la pregunta correcta del framework de orquestación de LLM que hay que hacer.
Preguntas frecuentes
Aquí hay preguntas de seguimiento comunes que van más allá de lo cubierto en el artículo principal.
¿Necesitan realmente los equipos pequeños un orquestador de LLM, o es solo para grandes empresas?
Prototipos muy pequeños y de bajo riesgo pueden depender de llamadas directas a LLM sin una capa de orquestación separada. Pero en el momento en que un equipo ejecuta múltiples casos de uso, trabaja con más de un modelo o proveedor, o se implementa en un entorno donde la fiabilidad importa, un orquestador ahorra una cantidad significativa de tiempo de ingeniería y reduce el riesgo operativo. Muchos frameworks de orquestación de LLM, incluidas las opciones de código abierto, son lo suficientemente ligeros para startups. BridgeApp se dirige específicamente a equipos de ingeniería que desean una automatización de nivel de producción sin construir su propio motor de orquestación desde cero, lo que lo hace accesible mucho antes del nivel empresarial.
¿En qué se diferencia un orquestador de LLM de una pasarela de IA o un proxy de API?
Una pasarela de IA se centra en el acceso unificado, la facturación, la limitación de velocidad y el enrutamiento básico entre proveedores de LLM, esencialmente la gestión del tráfico para las interacciones de modelos. Un orquestador añade lógica de flujo de trabajo, coordinación de herramientas, gestión de contexto, encadenamiento de prompts y evaluación además del enrutamiento puro. Algunas plataformas modernas combinan ambos roles en un sistema unificado, pero conceptualmente el orquestador maneja la lógica de aplicación de nivel superior y la gestión de recursos de LLM, no solo la proxyficación de solicitudes.
¿Puede un solo orquestador gestionar modelos de lenguaje de código cerrado y código abierto?
Sí. La mayoría de las capas de orquestación modernas están diseñadas para funcionar con backends de modelos heterogéneos: APIs alojadas (OpenAI, Anthropic, Google) y modelos de código abierto autoalojados o alojados en la nube (Llama, Mixtral y otros). La capa de modelos de BridgeApp sigue este patrón, abstrayéndose de múltiples proveedores para que la lógica de orquestación, los flujos y las reglas de gobernanza no dependan de un solo proveedor, lo que permite una verdadera optimización de costos en el panorama de modelos.
¿No es suficiente la llamada a funciones dentro de un LLM? ¿Por qué sigo necesitando orquestación?
La llamada a herramientas o funciones incorporada permite a un modelo decidir cuándo invocar herramientas específicas durante un solo turno de conversación, pero no reemplaza la gestión del estado entre solicitudes, los reintentos, la programación o la coordinación multiagente. Tampoco maneja las políticas de gobernanza en una organización. La orquestación y la llamada a funciones son complementarias: el orquestador define la caja de herramientas, establece las reglas y controla el entorno, mientras que el LLM decide tácticamente qué herramienta usar dentro de esos límites.
¿Cómo se diferencia la orquestación de BridgeApp de las herramientas genéricas de automatización de flujos de trabajo?
Las herramientas genéricas de flujo de trabajo orquestan APIs y tareas humanas, pero no tienen conciencia arquitectónica para bases de código, pipelines de IA multiagente o gestión de tokens y costos. El motor de orquestación de BridgeApp está diseñado específicamente para pipelines de desarrollo autónomos: comprende los repositorios a través de la inteligencia de la base de código (análisis global del código de los llamantes, cadenas de llamadas, rastreos entre servicios), utiliza una capa de modelo LLM para el enrutamiento inteligente entre proveedores, aplica una gobernanza estricta y una ejecución en sandbox, y gestiona la memoria del agente entre sesiones, capacidades que las plataformas genéricas de flujo de trabajo simplemente no ofrecen.