BlogAperçus de l'industrie
Différence entre LLM et Orchestrateur : Pourquoi c'est important pour les systèmes d'IA réels
Équipe BridgeApp
15 min de lecture
Si vous construisez quelque chose au-delà d'un prototype de chatbot, vous vous êtes probablement posé cette question : où se termine le travail du modèle et où commence le système qui l'entoure ? Cet article explique la différence pratique entre les grands modèles de langage et les orchestrateurs, pourquoi cette distinction est importante et comment ils fonctionnent ensemble dans l'IA de production.
Points clés à retenir
- Un grand modèle de langage (LLM) est le moteur prédictif qui génère du texte, raisonne sur les instructions et produit des résultats. Un orchestrateur est la couche de contrôle qui gère les flux de travail, les outils, les données et plusieurs modèles autour de lui. Ce sont des composants architecturaux fondamentalement différents.
- Les applications d'IA modernes – des chatbots et agents d'IA aux outils de développement – ont besoin des deux : les LLM pour le raisonnement et la génération, l'orchestration pour la fiabilité, la gouvernance et l'intégration transparente avec les systèmes réels.
- L'orchestration des LLM couvre le routage intelligent, l'appel d'outils, la gestion du contexte, l'historique des conversations et l'observabilité entre les fournisseurs comme OpenAI, Anthropic, DeepSeek et autres.
- Confondre un LLM avec un système d'IA complet conduit à des prototypes fragiles qui échouent en production. Comprendre où s'arrêtent les capacités des LLM et où commence l'orchestration est la première étape vers la construction d'applications d'IA maintenables.
- Des plateformes comme BridgeApp utilisent un moteur d'orchestration spécialement conçu pour transformer les capacités brutes des LLM en systèmes d'IA de qualité production et gouvernés – en particulier pour les pipelines d'automatisation du développement.
1. Introduction : Pourquoi « LLM vs. Orchestrateur » est une véritable question architecturale
Imaginez un scénario de plus en plus courant en 2025-2026 : une équipe d'ingénierie a construit une preuve de concept à l'aide d'une seule API LLM. Cela a bien fonctionné lors des démonstrations. Maintenant, la direction veut qu'elle fonctionne en production – gérant les données clients, appelant des API internes, basculant entre plusieurs modèles d'IA en fonction des coûts et de la latence, enregistrant chaque action pour la conformité et se récupérant gracieusement en cas de panne d'un fournisseur.
L'équipe réalise rapidement que « appeler l'API OpenAI » et « avoir un système d'IA » ne sont pas la même chose.
Cette confusion est au cœur de la question LLM vs. orchestrateur. Voici comment y penser :
- LLM / grand modèle de langage = un modèle probabiliste qui prédit du texte. Il génère, raisonne et résume – mais il ne gère pas les flux de travail, n'accède pas à votre base de données et ne connaît pas vos règles métier.
- Orchestrateur / couche d'orchestration = le système de coordination et de contrôle autour d'un ou plusieurs modèles. Il décide quoi appeler, quand, avec quel contexte et quoi faire du résultat.
Le reste de cet article va :
- Comparer les rôles et responsabilités de chaque composant.
- Montrer comment ils fonctionnent ensemble dans les applications pilotées par LLM.
- Fournir des conseils sur le moment d'investir dans les outils d'orchestration.
L'accent est mis ici sur l'ingénierie pratique pour les applications d'IA, et non sur la recherche de modèles.
2. Qu'est-ce qu'un LLM (Grand Modèle de Langage) ?
Un grand modèle de langage est un réseau neuronal entraîné sur de vastes corpus de texte pour prédire le jeton suivant. Si vous avez utilisé GPT-4o, Claude 3.5 Sonnet, Gemini 1.5 Pro ou Llama 3.1, vous avez interagi avec un LLM. Ce sont les moteurs de raisonnement fondamentaux derrière la plupart des applications d'IA génératives actuelles.
Capacités principales des grands modèles de langage (LLM) :
- Compréhension et génération du langage naturel – de la synthèse à l'écriture créative en passant par la production de code.
- Raisonnement sur les instructions, le code et les documents lorsqu'on leur donne les invites appropriées.
- Utilisation limitée d'outils lorsqu'ils sont enveloppés par du code ou des protocoles externes (par exemple, des spécifications d'appel de fonction).
Limitations intrinsèques qui comptent pour la conception du système :
- Pas de logique métier, de planification ou d'état de flux de travail intégrés. Un LLM ne « sait » pas qu'il s'agit de l'étape 3 d'un pipeline en 7 étapes.
- Fenêtre de contexte fixe et date limite de connaissance (généralement 2024-2025 pour les modèles actuels). Les informations au-delà de cette limite sont invisibles à moins d'être injectées.
- Pas d'accès direct aux bases de données, aux API ou à votre infrastructure sans une couche externe médiatisant la connexion.
Dans la plupart des systèmes d'IA de production, il n'y a pas un seul modèle LLM qui alimente tout. Les équipes utilisent plusieurs instances de LLM – différents fournisseurs, tailles et réglages fins – en sélectionnant celle qui convient à chaque tâche. Un modèle léger gère la classification ; un modèle haute capacité gère le raisonnement complexe ; un réglage fin spécialisé gère la génération spécifique à un domaine. Cette logique de sélection ? Elle ne fait pas partie du LLM lui-même. Elle appartient à l'orchestrateur.
3. Qu'est-ce qu'un orchestrateur dans les systèmes d'IA ?
Un orchestrateur — ou couche d'orchestration — est le composant système qui :
- Gère les flux de travail impliquant un ou plusieurs LLM, outils et sources de données.
- Décide quel modèle appeler, avec quelle invite et quel contexte, et quoi faire du résultat.
Comme le disent les praticiens d'IBM, « l'orchestration LLM aide à inviter, enchaîner, gérer et surveiller les grands modèles de langage… facilitant l'accès et la récupération des données… gérant les invites, l'interaction API, la récupération des données et la gestion de l'état dans les conversations. »
Responsabilités typiques d'un orchestrateur :
- Gestion des flux de travail et des états (flux multi-agents avec embranchements et dépendances).
- Routage intelligent entre les modèles et les outils – y compris l'équilibrage de charge et l'optimisation des coûts.
- Gestion des erreurs, des nouvelles tentatives, de la limitation de débit, du basculement et de la journalisation entre les fournisseurs LLM.
- Gestion du contexte et persistance de la mémoire entre les sessions et les agents.
- Gouvernance d'entreprise : politiques, autorisations, pistes d'audit et application de la conformité.
En 2026, cela est généralement mis en œuvre via :
- Des frameworks d'orchestration (par exemple, LangChain, LlamaIndex, Semantic Kernel).
- Des passerelles d'IA et des plateformes d'orchestration (routeurs multi-fournisseurs avec observabilité).
- Des moteurs d'orchestration personnalisés intégrés dans des plateformes comme BridgeApp, qui encapsulent ces capacités dans un système opinionné et prêt pour la production pour l'automatisation du développement.
La distinction essentielle : l'orchestrateur n'est pas un modèle. C'est une couche architecturale – code plus runtime – qui utilise les modèles de langage comme composants. Il ne génère pas de texte. Il gère tout ce qui entoure la génération.
4. Différence fondamentale : « Cerveau » vs. « Plan de contrôle »
La façon la plus simple de comprendre la différence : un LLM est le « cerveau » statistique qui répond aux questions et génère du contenu. Un orchestrateur est le « plan de contrôle » qui décide quand, comment et sous quelles contraintes utiliser ce cerveau au sein d'un système d'IA plus vaste.
Pensez-y de cette façon :
- Le LLM est un consultant hautement qualifié qui sait lire, écrire et raisonner – mais il n'a pas d'agenda, pas de système de gestion de projet, pas d'accès à vos bases de données internes et aucun souvenir de la réunion de la semaine dernière.
- L'orchestrateur est le chef de projet et le moteur de workflow – il attribue les tâches, définit l'ordre, valide les résultats et intègre les résultats aux systèmes de l'entreprise.
Différences explicites dimension par dimension :
- Focus : Prédiction et génération de texte vs. gestion du flux de tâches et de données à travers des processus complexes.
- Portée : Une seule interaction ou un fil de conversation vs. un processus métier multi-étapes entier qui peut s'étendre sur des heures ou des jours.
- Entrées/sorties : Invites et jetons (entrées et sorties LLM) vs. événements, travaux, appels API et charges utiles structurées.
- Responsabilité : Correction d'une seule réponse (qualité de sortie) vs. fiabilité, auditabilité et coût sur de nombreux appels LLM.
- État : Sans état entre les appels API (le LLM oublie) vs. gestion d'état persistante (l'orchestrateur se souvient et suit).
- Gouvernance : Pas de politiques innées (le LLM fait ce que l'invite dit) vs. contrôle centralisé sur les autorisations, l'accès aux outils et la conformité.
Les deux sont nécessaires. L'IA de production dépend d'une couche de modèle solide et d'une couche d'orchestration disciplinée travaillant ensemble.
5. Où les LLM s'arrêtent et les orchestrateurs commencent : la répartition des responsabilités
Tracer une ligne claire entre ce qui appartient au « travail » du LLM et ce que gère l'orchestrateur évite la confusion architecturale et les systèmes fragiles.
Ce qui se trouve du côté du LLM :
- Raisonnement en langage naturel, résumé, génération de contenu – les capacités fondamentales du LLM.
- Prise de décision locale lorsque l'orchestrateur lui fournit des contraintes et des outils clairs (par exemple, choisir la bonne fonction à appeler en fonction de la question d'un utilisateur).
- Production de sorties structurées, rédaction de code, traduction entre langues ou formats.
Ce qui appartient à l'orchestrateur :
- État de longue durée (par exemple, un flux de travail d'intégration d'une semaine ou un sprint de développement de plusieurs jours avec un historique de conversation persistant).
- Gestion des données : récupération à partir de bases de données vectorielles, de magasins SQL, d'API et injection de données contextuelles dans les invites.
- Planification, tentatives, retours en arrière et gestion des limites de débit sur plusieurs fournisseurs LLM.
- Décisions de routage de modèle : quel fournisseur, quelle taille de modèle, quelle région.
- Application de la gouvernance : qui peut accéder à quels outils, ce qui est enregistré, quand les humains doivent approuver.
Scénarios concrets qui illustrent la séparation :
- Assistant de support client : Une demande d'utilisateur déclenche l'orchestrateur pour récupérer les données de commande d'un CRM (via API), récupérer les documents pertinents d'une base de connaissances (base de données vectorielle), puis appeler un LLM pour rédiger une réponse. Si le sentiment du client est de la colère, l'orchestrateur escalade vers un agent humain. Le LLM produit le brouillon ; l'orchestrateur relie toutes les étapes, gère la logique d'escalade et enregistre l'interaction.
- Pipeline d'automatisation de développement : Une tâche arrive (« ajouter la fonctionnalité X »). L'orchestrateur utilise un agent de planification pour concevoir l'approche, un agent de code pour implémenter, un agent de révision de code pour évaluer, puis s'intègre au dépôt de code et au pipeline CI. Les LLM alimentent le raisonnement de chaque agent ; l'orchestrateur alimente le flux, les dépendances et les transitions d'état.
Essayer de pousser les responsabilités d'orchestration dans l'ingénierie pure des invites devient rapidement ce que les équipes expérimentées appellent des « prompts spaghetti » – des chaînes d'instructions fragiles qui se cassent de manière imprévisible à mesure que la complexité augmente.
6. L'orchestration LLM en pratique : les tâches gérées par l'orchestrateur
Voici ce qu'une bonne orchestration LLM fait réellement dans une pile réelle – une liste de contrôle concise des responsabilités que gère l'orchestration :
Enchaînement d'invites et appels LLM multi-étapes :
- Lier plusieurs appels LLM tout en préservant le contexte et les résultats intermédiaires. La sortie d'un modèle devient l'entrée d'un autre, avec des modèles d'invites et des exemples en peu de coups gérés par l'orchestrateur.
- Gérer la logique de branchement : si le premier appel classe une demande comme « facturation », la router vers des invites spécifiques à la facturation ; si « technique », la router vers une chaîne différente.
Intégration LLM entre les fournisseurs :
- Interfaces standard pour plusieurs fournisseurs et modèles LLM (OpenAI, Anthropic, Mistral, modèles locaux). Une interface unifiée signifie que le changement ou l'ajout de fournisseurs ne nécessite pas de réécrire la logique de l'application.
- Prise en charge de plusieurs instances LLM simultanément pour les tests A/B ou le traitement parallèle des requêtes concurrentes.
Gestion des données et génération augmentée par récupération :
- Récupération et préparation du contexte via RAG – interrogation de bases de données vectorielles et de magasins de documents, puis nettoyage et structuration des charges utiles avant qu'elles n'atteignent le modèle.
- Prétraitement des données : filtrage, découpage et réordonnancement des documents récupérés afin que le LLM ne reçoive que les données contextuelles pertinentes.
Routage intelligent :
- Envoyer les tâches simples à des modèles moins chers et plus rapides, et les tâches de raisonnement complexes à des modèles haut de gamme, optimisant l'utilisation des ressources et contrôlant les coûts.
- Basculement automatique lorsqu'un fournisseur est en panne ou soumis à des limites de débit, avec des disjoncteurs et un équilibrage de charge.
Gestion de la mémoire :
- L'orchestrateur gère l'historique des conversations au-delà de la fenêtre de contexte du modèle, compressant ou résumant les tours précédents.
- Mémoire à long terme externalisée pour les agents IA à travers les sessions – afin qu'un agent « se souvienne » des interactions passées sans tout insérer dans l'invite.
Les frameworks d'orchestration LLM tels que LangChain ou LlamaIndex offrent des blocs de construction pour ces tâches. Des plateformes comme BridgeApp encapsulent des capacités similaires dans un moteur opinionné – gérant l'orchestration, le routage des modèles et la gouvernance dans un système unifié plutôt que d'exiger des équipes qu'elles assemblent des pièces.
7. LLM vs. Orchestrateur dans les configurations multi-agents et agents d'IA
Les systèmes multi-agents sont l'un des modèles déterminants de l'architecture d'IA de 2025-2026. Au lieu d'une seule invite monolithique, différents agents basés sur des rôles – chercheur, codeur, relecteur, planificateur – collaborent sur des tâches complexes. C'est là que la différence entre LLM et orchestrateur devient la plus visible.
Comment les rôles se répartissent dans les configurations multi-agents :
- Chaque agent d'IA est généralement alimenté par un ou plusieurs LLM (le cœur de raisonnement). L'« intelligence » de l'agent provient du modèle de langage.
- L'orchestrateur coordonne les agents : attribution des tâches, ordonnancement des dépendances, délais d'attente, résolution des conflits et mémoire partagée. La « fiabilité » de l'agent provient de l'orchestration.
Un pipeline d'agents typique ressemble à ceci :
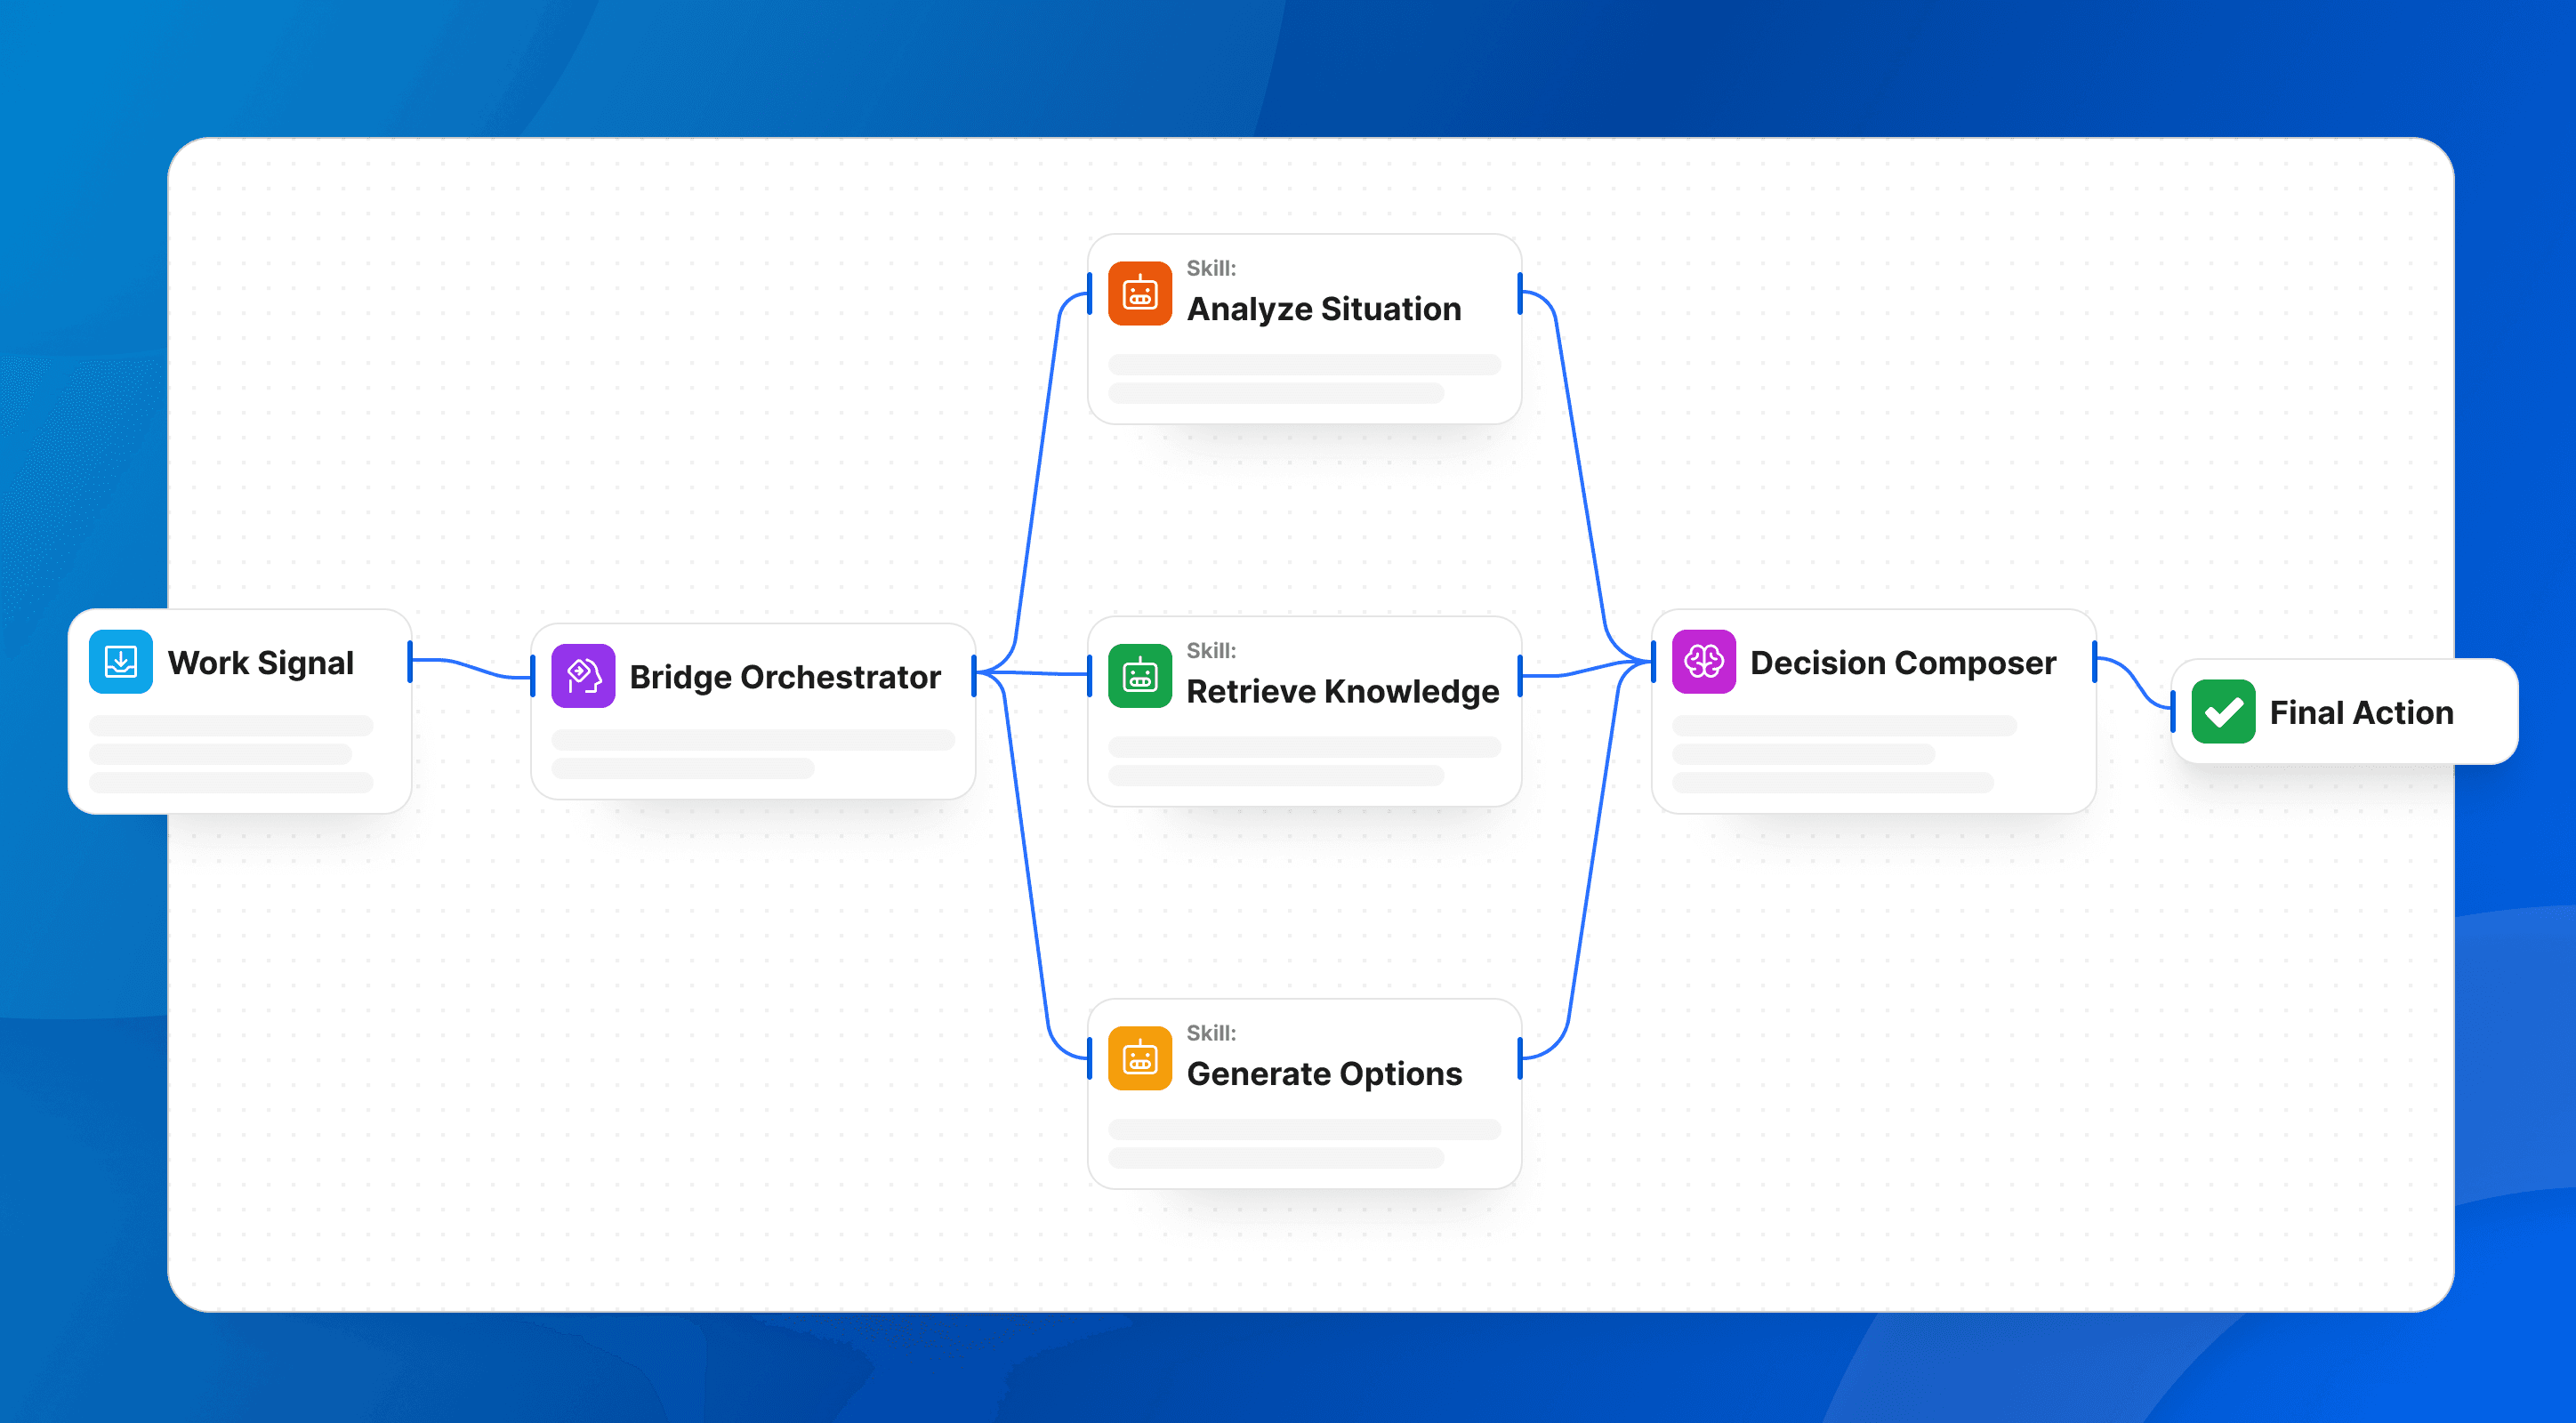
Agent de recherche → agent de planification → agent d'exécution → agent d'assurance qualité, tous coordonnés par une couche d'orchestration qui gère les transferts, suit l'état et applique les règles.
Pourquoi l'orchestration est essentielle pour plusieurs agents d'IA :
- Éviter les blocages : les agents s'attendent mutuellement dans des dépendances circulaires.
- Appliquer les limites de budget, d'utilisation des jetons et de temps. Sans cela, les boucles d'agents peuvent consommer des ressources à l'infini.
- Maintenir une source de vérité partagée pour le contexte et la mémoire, afin que les agents ne se contredisent pas ou ne répètent pas le travail.
- Gérer l'exécution parallèle si sûr, et sérialiser si l'ordre est important.
Magic Coder de BridgeApp utilise exactement ce modèle : un pipeline multi-agents avec des agents Team Lead, System Architect, Developer, Code Reviewer et QA – tous gérés par un moteur d'orchestration. Le pipeline applique des boucles de révision (révision du plan, révision du code local) et s'arrête à « En attente de fusion » par conception, afin que les humains approuvent les modifications finales. Les LLM effectuent le raisonnement ; l'orchestrateur s'assure que le processus est contrôlé et maintenable.
8. Orchestration LLM pour les données et le contexte : RAG, mémoire et « Vérité »
Les grands modèles de langage ne « connaissent » pas intrinsèquement vos données privées, ni ne conservent une mémoire à long terme entre les appels. Chaque appel commence à zéro, à moins que quelque chose d'extérieur n'assure la continuité. C'est là que la récupération des données et la gestion du contexte deviennent des préoccupations essentielles de l'orchestration.
La Génération augmentée par récupération (RAG) est le modèle dominant pour ancrer les réponses LLM dans des données réelles. L'orchestrateur interroge des sources de connaissances – une base de données vectorielle, un magasin SQL ou une API – récupère les documents pertinents et les injecte dans l'invite avant que le LLM ne génère une réponse. Le modèle lui-même ne « recherche » pas ; la couche d'orchestration gère la recherche web, les requêtes de base de données et le prétraitement des données.
Comment l'orchestrateur gère le contexte pour les applications LLM augmentées par le contexte :
- Sélection des documents ou faits à inclure en fonction du score de pertinence et du contrôle d'accès.
- Compression et résumé de l'historique pour tenir dans les limites de jetons – afin que le modèle reçoive le signal maximal avec un minimum de jetons.
- Application de ré-classement ou de filtres pour maintenir le contexte pertinent et éviter les hallucinations dues à des données non pertinentes.
Vérification de la sortie comme responsabilité d'orchestration :
- Vérification croisée des réponses LLM par rapport aux bases de connaissances avant de les livrer aux utilisateurs.
- Exécution d'un modèle « critique » ou évaluateur séparé pour les sorties risquées – un modèle où l'orchestrateur appelle un second modèle LLM spécifiquement pour le contrôle qualité.
Rien de tout cela n'est fait par le LLM seul. La gestion des données, l'ingénierie du contexte et la vérification des faits sont des tâches d'orchestration – des parties fondamentales de la construction d'applications LLM sophistiquées auxquelles les utilisateurs peuvent faire confiance.
9. Fiabilité, sécurité et gouvernance : pourquoi l'orchestration est un impératif
Les appels LLM bruts ne peuvent pas résoudre plusieurs problèmes de fiabilité par eux-mêmes :
- Les pannes de fournisseurs, les limites de débit et les erreurs réseau transitoires sont des faits de la vie lorsque l'on travaille avec des points de terminaison d'API LLM externes.
- Les sorties non déterministes des LLM entraînent un comportement incohérent entre les exécutions – la même invite peut produire des résultats différents.
Comment l'orchestrateur aborde la fiabilité :
- Les tentatives avec un mécanisme de temporisation exponentiel, les disjoncteurs et la mise en file d'attente garantissent qu'un seul problème de fournisseur ne fait pas planter le flux de travail.
- La mise en cache sémantique et l'idempotence pour les flux de travail de longue durée évitent la duplication du travail et réduisent les coûts.
- Surveillance des performances et suivi des performances entre les fournisseurs, avec des métriques clés comme la latence, les taux d'erreur et les métriques de performance pour l'économie des jetons.
Sécurité et gouvernance d'entreprise :
- Politiques centrales pour savoir quels modèles et quels outils peuvent accéder à quelles données. L'orchestration gère les autorisations des outils à un niveau granulaire.
- Journaux d'audit des invites, des réponses LLM et des appels d'outils pour la conformité – essentiels dans les industries réglementées comme la finance et la santé.
- Environnements d'exécution isolés qui séparent le code piloté par LLM de l'infrastructure de production.
C'est là que les plateformes d'orchestration sérieuses diffèrent de « simplement appeler l'API ». BridgeApp, par exemple, exécute les automatisations pilotées par LLM dans des bacs à sable micro-VM isolés, applique des règles d'autorisation en couches à chaque outil auquel un agent peut accéder et enregistre chaque étape pour examen humain. Les secrets sont chiffrés au repos, les identifiants Git sont de courte durée et délimités, et chaque mutation d'authentification est auditée – le type de gouvernance que les interactions brutes des modèles ne peuvent tout simplement pas fournir.
10. Comment BridgeApp utilise l'orchestration pour transformer les LLM en une véritable automatisation du développement
Pour ancrer ces concepts dans une plateforme d'applications pilotées par LLM du monde réel, considérons comment BridgeApp et Magic Coder de BridgeApp implémentent l'architecture LLM + orchestrateur pour le cycle de vie du développement logiciel (SDLC).
Le pipeline de développement multi-agents au sein de BridgeApp :
- Agent Team Lead - prise en charge, tri et orchestration des tâches ; attribue le travail et approuve les plans.
- Agent System Architect - inspecte le code et les exigences ; rédige le plan d'implémentation.
- Agents développeurs (backend / UI) - implémentent les plans approuvés, écrivent des tests et des documents, ouvrent des PR.
- Agents Code Reviewer et QA - évaluent le code par rapport au plan, détectent les problèmes avant la fusion.
Ce que gère le moteur d'orchestration :
- Transitions d'état : À faire → Planification → Révision du plan → Exécution → Révision du code local → En attente de fusion. Chaque état a des conditions d'entrée/sortie claires, et les agents ne font jamais avancer une tâche à l'état « Terminé » – le pipeline s'arrête à « En attente de fusion » pour que les humains examinent le résultat final.
- Parallélisation du travail entre plusieurs agents IA lorsque cela est sûr, et reprise à partir du dernier point de contrôle après des échecs.
Connexion aux concepts antérieurs :
- Routage intelligent entre différents fournisseurs de LLM via une couche de modèle unifiée (OpenAI, Anthropic, DeepSeek et autres) – l'orchestrateur choisit le bon modèle pour la tâche de chaque agent.
- Gestion des données à l'aide de bases de connaissances et de graphes de code (analyse globale du code des appelants, des chaînes d'appels, des traces inter-services) pour donner à chaque agent les données contextuelles appropriées.
- Gouvernance avec des compétences, des règles et une exécution en sandbox explicites – chaque agent opère dans des limites définies.
L'objectif ici n'est pas un argument de vente. C'est de montrer que la distinction abstraite entre LLM et orchestrateur correspond directement à la façon dont les systèmes réels sont construits : les modèles raisonnent, et l'orchestrateur s'assure que ce raisonnement se produit de manière fiable dans un pipeline contrôlé et auditable.
11. Quand avez-vous besoin d'un orchestrateur vs. « juste un LLM » ?
Tous les cas d'utilisation de l'IA ne nécessitent pas une plateforme d'orchestration complète. Voici les cas où un simple appel d'API LLM suffit :
- Génération de contenu ponctuelle – rédaction d'un article de blog, résumé d'un document.
- Questions-réponses simples sur des connaissances web publiques – pas de données privées, pas de logique multi-étapes.
- Prototypes ou expériences internes où la vitesse est plus importante que la fiabilité.
Contrastez cela avec les situations où l'orchestration de l'IA devient non négociable :
- Plusieurs modèles, fournisseurs ou régions avec des exigences d'optimisation des coûts.
- Flux de travail LLM multi-étapes avec des outils, des bases de données et des systèmes externes.
- Besoin d'observabilité, de SLA et de gouvernance à l'échelle de l'équipe – suivi des performances, pistes d'audit, contrôles des coûts.
- Scénarios impliquant plusieurs agents IA qui se coordonnent sur des tâches complexes.
Une simple liste de contrôle pour les chefs de projet :
- Devez-vous appeler plus d'un outil ou d'un modèle ? → Envisagez l'orchestration.
- Avez-vous besoin de journaux d'audit, de suivi des coûts et de routage des modèles ? → Vous avez besoin d'un orchestrateur.
- Les équipes non techniques dépendront-elles de ce système d'IA pour les processus métier essentiels ? → Investissez tôt dans l'orchestration.
Une étude de recherche de 2026 évaluant l'orchestration LLM a montré que l'orchestration améliorait la précision d'environ 4 à 5 points de pourcentage par rapport aux bases de référence optimisées de la chaîne de pensée, mais s'accompagnait d'un coût en jetons environ 2 à 4 fois plus élevé. Le compromis est réel, et il vaut la peine de le faire délibérément plutôt que de le découvrir après que votre prototype arrive en production.
Si vous construisez un système qui compte, pensez « LLM + orchestrateur » dès le départ plutôt que d'ajouter l'orchestration après que les choses se cassent.
12. Résumé : LLM, orchestrateurs et l'avenir des applications d'IA
- Les LLM sont les moteurs de raisonnement et de génération – ils produisent l'intelligence.
- Les orchestrateurs sont les couches d'exécution, de routage et de gouvernance – ils produisent la fiabilité.
- Les systèmes d'IA évolutifs et les agents d'IA nécessitent que les deux travaillent ensemble, chacun gérant ce qu'il fait le mieux.
L'orchestration des LLM est désormais aussi fondamentale que le modèle lui-même pour l'IA de production. Dans les architectures multi-modèles et multi-agents de 2025-2026, la couche d'orchestration est ce qui sépare une démo d'un produit. Des plateformes comme BridgeApp combinent l'intégration LLM, l'orchestration et les meilleures pratiques d'automatisation du développement afin que les équipes puissent aller au-delà des prototypes vers des pipelines SDLC fiables basés sur l'IA – avec des capacités d'équipe qui évoluent à mesure que l'organisation grandit.
Examinez attentivement votre architecture actuelle. Où les appels LLM bruts effectuent-ils un « travail d'orchestration caché » enfoui dans le code ou les invites ? Où une couche d'orchestration dédiée – qu'il s'agisse de frameworks d'orchestration open source, d'une plateforme d'orchestration gérée ou d'un moteur spécialement conçu – pourrait-elle simplifier, renforcer et rendre votre système observable ? C'est la bonne question à poser pour le cadre d'orchestration LLM.
FAQ
Voici des questions de suivi courantes qui vont au-delà de ce qui est couvert dans l'article principal.
Les petites équipes ont-elles vraiment besoin d'un orchestrateur LLM, ou est-ce uniquement pour les grandes entreprises ?
Les très petits prototypes à faible risque peuvent s'appuyer sur des appels LLM directs sans couche d'orchestration distincte. Mais dès qu'une équipe exécute plusieurs cas d'utilisation, travaille avec plus d'un modèle ou fournisseur, ou déploie dans un environnement où la fiabilité est importante, un orchestrateur permet d'économiser un temps d'ingénierie considérable et réduit les risques opérationnels. De nombreux frameworks d'orchestration LLM – y compris des options open source – sont suffisamment légers pour les startups. BridgeApp cible spécifiquement les équipes d'ingénierie qui souhaitent une automatisation de qualité production sans construire leur propre moteur d'orchestration à partir de zéro, ce qui le rend accessible bien en dessous du niveau entreprise.
En quoi un orchestrateur LLM diffère-t-il d'une passerelle d'IA ou d'un proxy d'API ?
Une passerelle d'IA se concentre sur l'accès unifié, la facturation, la limitation de débit et le routage de base entre les fournisseurs LLM – essentiellement la gestion du trafic pour les interactions des modèles. Un orchestrateur ajoute la logique de flux de travail, la coordination des outils, la gestion du contexte, l'enchaînement des invites et l'évaluation en plus du routage brut. Certaines plateformes modernes combinent les deux rôles en un système unifié, mais conceptuellement, l'orchestrateur gère la logique d'application de niveau supérieur et la gestion des ressources LLM, pas seulement la proxyfication des requêtes.
Un seul orchestrateur peut-il gérer à la fois les modèles de langage propriétaires et open source ?
Oui. La plupart des couches d'orchestration modernes sont conçues pour fonctionner avec des backends de modèles hétérogènes : des API hébergées (OpenAI, Anthropic, Google) et des modèles open source auto-hébergés ou hébergés dans le cloud (Llama, Mixtral et autres). La couche de modèles de BridgeApp suit ce modèle, s'abstraire de plusieurs fournisseurs afin que la logique d'orchestration, les flux et les règles de gouvernance ne dépendent pas d'un seul fournisseur – permettant une véritable optimisation des coûts sur l'ensemble du paysage des modèles.
La fonction d'appel au sein d'un LLM n'est-elle pas suffisante ? Pourquoi ai-je encore besoin d'orchestration ?
L'appel d'outils ou de fonctions intégré permet à un modèle de décider quand invoquer des outils spécifiques lors d'un seul tour de conversation, mais il ne remplace pas la gestion d'état inter-requêtes, les tentatives, la planification ou la coordination multi-agents. Il ne gère pas non plus les politiques de gouvernance au sein d'une organisation. L'orchestration et l'appel de fonctions sont complémentaires : l'orchestrateur définit la boîte à outils, établit les règles et contrôle l'environnement, tandis que le LLM décide tactiquement quel outil utiliser dans ces limites.
En quoi l'orchestration de BridgeApp diffère-t-elle des outils génériques d'automatisation des flux de travail ?
Les outils génériques de workflow orchestrent les API et les tâches humaines, mais ils n'ont pas de conscience architecturale pour les bases de code, les pipelines d'IA multi-agents ou la gestion des jetons et des coûts. Le moteur d'orchestration de BridgeApp est conçu spécifiquement pour les pipelines de développement autonomes : il comprend les dépôts grâce à l'intelligence de la base de code (analyse globale du code des appelants, des chaînes d'appels, des traces inter-services), utilise une couche de modèle LLM pour le routage intelligent entre les fournisseurs, applique une gouvernance stricte et une exécution en sandbox, et gère la mémoire des agents entre les sessions – des capacités que les plateformes génériques de workflow n'offrent tout simplement pas.