BlogInsights da indústria
Diferença Entre LLM e Orquestrador: Por Que Isso Importa Para Sistemas de IA Reais
Equipe BridgeApp
15 min de leitura
Se você está construindo algo além de um protótipo de chatbot, provavelmente já se deparou com esta pergunta: onde termina o trabalho do modelo e onde começa o sistema ao seu redor? Este artigo detalha a diferença prática entre grandes modelos de linguagem e orquestradores, por que essa distinção é importante e como eles trabalham juntos na IA de produção.
Pontos Chave
- Um grande modelo de linguagem (LLM) é o motor preditivo que gera texto, raciocina sobre instruções e produz saídas. Um orquestrador é a camada de controle que gerencia fluxos de trabalho, ferramentas, dados e múltiplos modelos ao seu redor. Eles são componentes arquitetônicos fundamentalmente diferentes.
- Aplicações modernas de IA - de chatbots e agentes de IA a ferramentas de desenvolvedor - precisam de ambos: LLMs para raciocínio e geração, orquestração para confiabilidade, governança e integração perfeita com sistemas reais.
- A orquestração de LLMs abrange roteamento inteligente, chamada de ferramentas, gerenciamento de contexto, histórico de conversas e observabilidade entre provedores como OpenAI, Anthropic, DeepSeek e outros.
- Confundir um LLM com um sistema de IA completo leva a protótipos frágeis que falham em produção. Compreender onde as capacidades de LLM terminam e a orquestração começa é o primeiro passo para construir aplicações de IA sustentáveis.
- Plataformas como o BridgeApp usam um motor de orquestração construído especificamente para transformar capacidades de LLM brutas em sistemas de IA governados e de nível de produção - particularmente para pipelines de automação de desenvolvimento.
1. Introdução: Por Que "LLM vs. Orquestrador" É Uma Questão Arquitetônica Real
Imagine um cenário cada vez mais comum em 2025–2026: uma equipe de engenharia construiu um prova de conceito usando uma única API de LLM. Funcionou bem em demonstrações. Agora a liderança quer que funcione em produção - lidando com dados de clientes, chamando APIs internas, alternando entre múltiplos modelos de IA com base no custo e latência, registrando cada ação para conformidade e recuperando-se graciosamente quando um provedor falha.
A equipe rapidamente percebe que "chamar a API da OpenAI" e "ter um sistema de IA" não são a mesma coisa.
Essa confusão está no cerne da questão LLM vs. orquestrador. Veja como pensar sobre isso:
- LLM / grande modelo de linguagem = um modelo probabilístico que prevê texto. Ele gera, raciocina e resume - mas não gerencia fluxos de trabalho, acessa seu banco de dados ou conhece suas regras de negócio.
- Orquestrador / camada de orquestração = o sistema de coordenação e controle em torno de um ou muitos modelos. Ele decide o que chamar, quando, com qual contexto e o que fazer com o resultado.
O restante deste artigo irá:
- Comparar os papéis e responsabilidades de cada componente.
- Mostrar como eles trabalham juntos em aplicações impulsionadas por LLMs.
- Fornecer orientação sobre quando investir em ferramentas de orquestração.
O foco aqui é a engenharia prática para aplicações de IA, não a pesquisa de modelos.
2. O Que É um LLM (Grande Modelo de Linguagem)?
Um grande modelo de linguagem é uma rede neural treinada em vastos corpos de texto para prever o próximo token. Se você usou GPT-4o, Claude 3.5 Sonnet, Gemini 1.5 Pro ou Llama 3.1, você interagiu com um LLM. Esses são os motores de raciocínio centrais por trás da maioria das aplicações de IA generativa hoje.
Principais capacidades dos grandes modelos de linguagem (LLMs):
- Compreensão e geração de linguagem natural - desde a sumarização à escrita criativa e à produção de código.
- Raciocínio sobre instruções, código e documentos quando fornecidos prompts apropriados.
- Uso limitado de ferramentas quando envolto por código ou protocolos externos (por exemplo, especificações de chamada de função).
Limitações intrínsecas que importam para o design do sistema:
- Nenhuma lógica de negócios, agendamento ou estado de fluxo de trabalho embutidos. Um LLM não "sabe" que está na etapa 3 de um pipeline de 7 etapas.
- Janela de contexto fixa e limite de conhecimento (tipicamente 2024–2025 para modelos atuais). Informações além desse limite são invisíveis, a menos que injetadas.
- Sem acesso direto a bancos de dados, APIs ou sua infraestrutura sem uma camada externa mediando a conexão.
Na maioria dos sistemas de IA em produção, não há um único modelo de LLM alimentando tudo. As equipes usam múltiplas instâncias de LLM - diferentes fornecedores, tamanhos e fine-tunes - selecionando o mais adequado para cada tarefa. Um modelo leve lida com classificação; um de alta capacidade lida com raciocínio complexo; um fine-tune especializado lida com geração específica de domínio. Essa lógica de seleção? Não faz parte do próprio LLM. Ela pertence ao orquestrador.
3. O Que É Um Orquestrador Em Sistemas de IA?
Um orquestrador - ou camada de orquestração - é o componente do sistema que:
- Gerencia fluxos de trabalho envolvendo um ou mais LLMs, ferramentas e fontes de dados.
- Decide qual modelo chamar, com qual prompt e contexto, e o que fazer com o resultado.
Como os profissionais da IBM colocam, "a orquestração de LLMs ajuda a solicitar, encadear, gerenciar e monitorar grandes modelos de linguagem… facilitando o acesso e a recuperação de dados… gerenciando prompts, interação de API, recuperação de dados e gerenciamento de estado em conversas."
Responsabilidades típicas de um orquestrador:
- Gerenciamento de fluxo de trabalho e estado (fluxos multiagente com ramificações e dependências).
- Roteamento inteligente entre modelos e ferramentas - incluindo balanceamento de carga e otimização de custos.
- Tratamento de erros, novas tentativas, limitação de taxa, failover e registro em log entre provedores de LLM.
- Gerenciamento de contexto e persistência de memória entre sessões e agentes.
- Governança empresarial: políticas, permissões, trilhas de auditoria e aplicação de conformidade.
Em 2026, isso é tipicamente implementado via:
- Estruturas de orquestração (por exemplo, LangChain, LlamaIndex, Semantic Kernel).
- Gateways de IA e plataformas de orquestração (roteadores multiprovedor com observabilidade).
- Motores de orquestração personalizados incorporados em plataformas como o BridgeApp, que encapsula essas capacidades em um sistema opinativo e pronto para produção para automação de desenvolvimento.
A distinção crítica: o orquestrador não é um modelo. É uma camada arquitetônica - código mais tempo de execução - que usa modelos de linguagem como componentes. Ele não gera texto. Ele gerencia tudo ao redor da geração.
4. Diferença Essencial: "Cérebro" vs. "Plano de Controle"
A maneira mais simples de entender a diferença: um LLM é o "cérebro" estatístico que responde a perguntas e gera conteúdo. Um orquestrador é o "plano de controle" que decide quando, como e sob quais restrições usar esse cérebro dentro de um sistema de IA maior.
Pense assim:
- O LLM é um consultor altamente qualificado que pode ler, escrever e raciocinar - mas não tem calendário, sistema de gerenciamento de projetos, acesso aos seus bancos de dados internos e nenhuma memória da reunião da semana passada.
- O orquestrador é o gerente de projetos mais o motor de fluxo de trabalho - atribuindo tarefas, definindo a ordem, validando saídas e integrando resultados com os sistemas da empresa.
Diferenças explícitas dimensão por dimensão:
- Foco: Previsão e geração de texto vs. gerenciamento de fluxo de tarefas e dados em processos complexos.
- Escopo: Uma única vez ou thread de conversação vs. um processo de negócio completo de várias etapas que pode durar horas ou dias.
- Entradas/saídas: Prompts e tokens (entradas e saídas de LLM) vs. eventos, jobs, chamadas de API e payloads estruturados.
- Responsabilidade: Correção de uma única resposta (qualidade da saída) vs. confiabilidade, auditabilidade e custo em muitas chamadas de LLM.
- Estado: Sem estado entre chamadas de API (o LLM esquece) vs. gerenciamento de estado persistente (o orquestrador lembra e rastreia).
- Governança: Nenhuma política inata (o LLM faz o que o prompt diz) vs. controle centralizado sobre permissões, acesso a ferramentas e conformidade.
Ambos são necessários. A IA de produção depende de uma camada de modelo robusta e de uma camada de orquestração disciplinada trabalhando juntas.
5. Onde os LLMs Terminam e os Orquestradores Começam: Divisão de Responsabilidades
Traçar uma linha clara entre o que pertence ao "trabalho" do LLM e o que o orquestrador lida evita confusão arquitetônica e sistemas frágeis.
O que reside no lado do LLM:
- Raciocínio em linguagem natural, sumarização, geração de conteúdo - as capacidades centrais do LLM.
- Tomada de decisão local quando fornecidas restrições e ferramentas claras pelo orquestrador (por exemplo, escolher a função certa para chamar com base na pergunta de um usuário).
- Produzir saídas estruturadas, redigir código, traduzir entre linguagens ou formatos.
O que pertence ao orquestrador:
- Estado de longa duração (por exemplo, um fluxo de trabalho de onboarding de uma semana ou um sprint de desenvolvimento de vários dias com histórico de conversas persistente).
- Gerenciamento de dados: recuperação de bancos de dados vetoriais, armazenamentos SQL, APIs e injeção de dados contextuais em prompts.
- Agendamento, novas tentativas, backoff e gerenciamento de limite de taxa em múltiplos provedores de LLM.
- Decisões de roteamento de modelo: qual provedor, qual tamanho de modelo, qual região.
- Aplicação de governança: quem pode acessar quais ferramentas, o que é registrado, quando humanos devem aprovar.
Cenários concretos que ilustram a divisão:
- Assistente de suporte ao cliente: Uma solicitação do usuário aciona o orquestrador para recuperar dados de pedidos de um CRM (via API), buscar documentos relevantes de uma base de conhecimento (banco de dados vetorial) e, em seguida, chamar um LLM para redigir uma resposta. Se o sentimento do cliente for de raiva, o orquestrador escala para um agente humano. O LLM produz o rascunho; o orquestrador conecta todas as etapas, lida com a lógica de escalonamento e registra a interação.
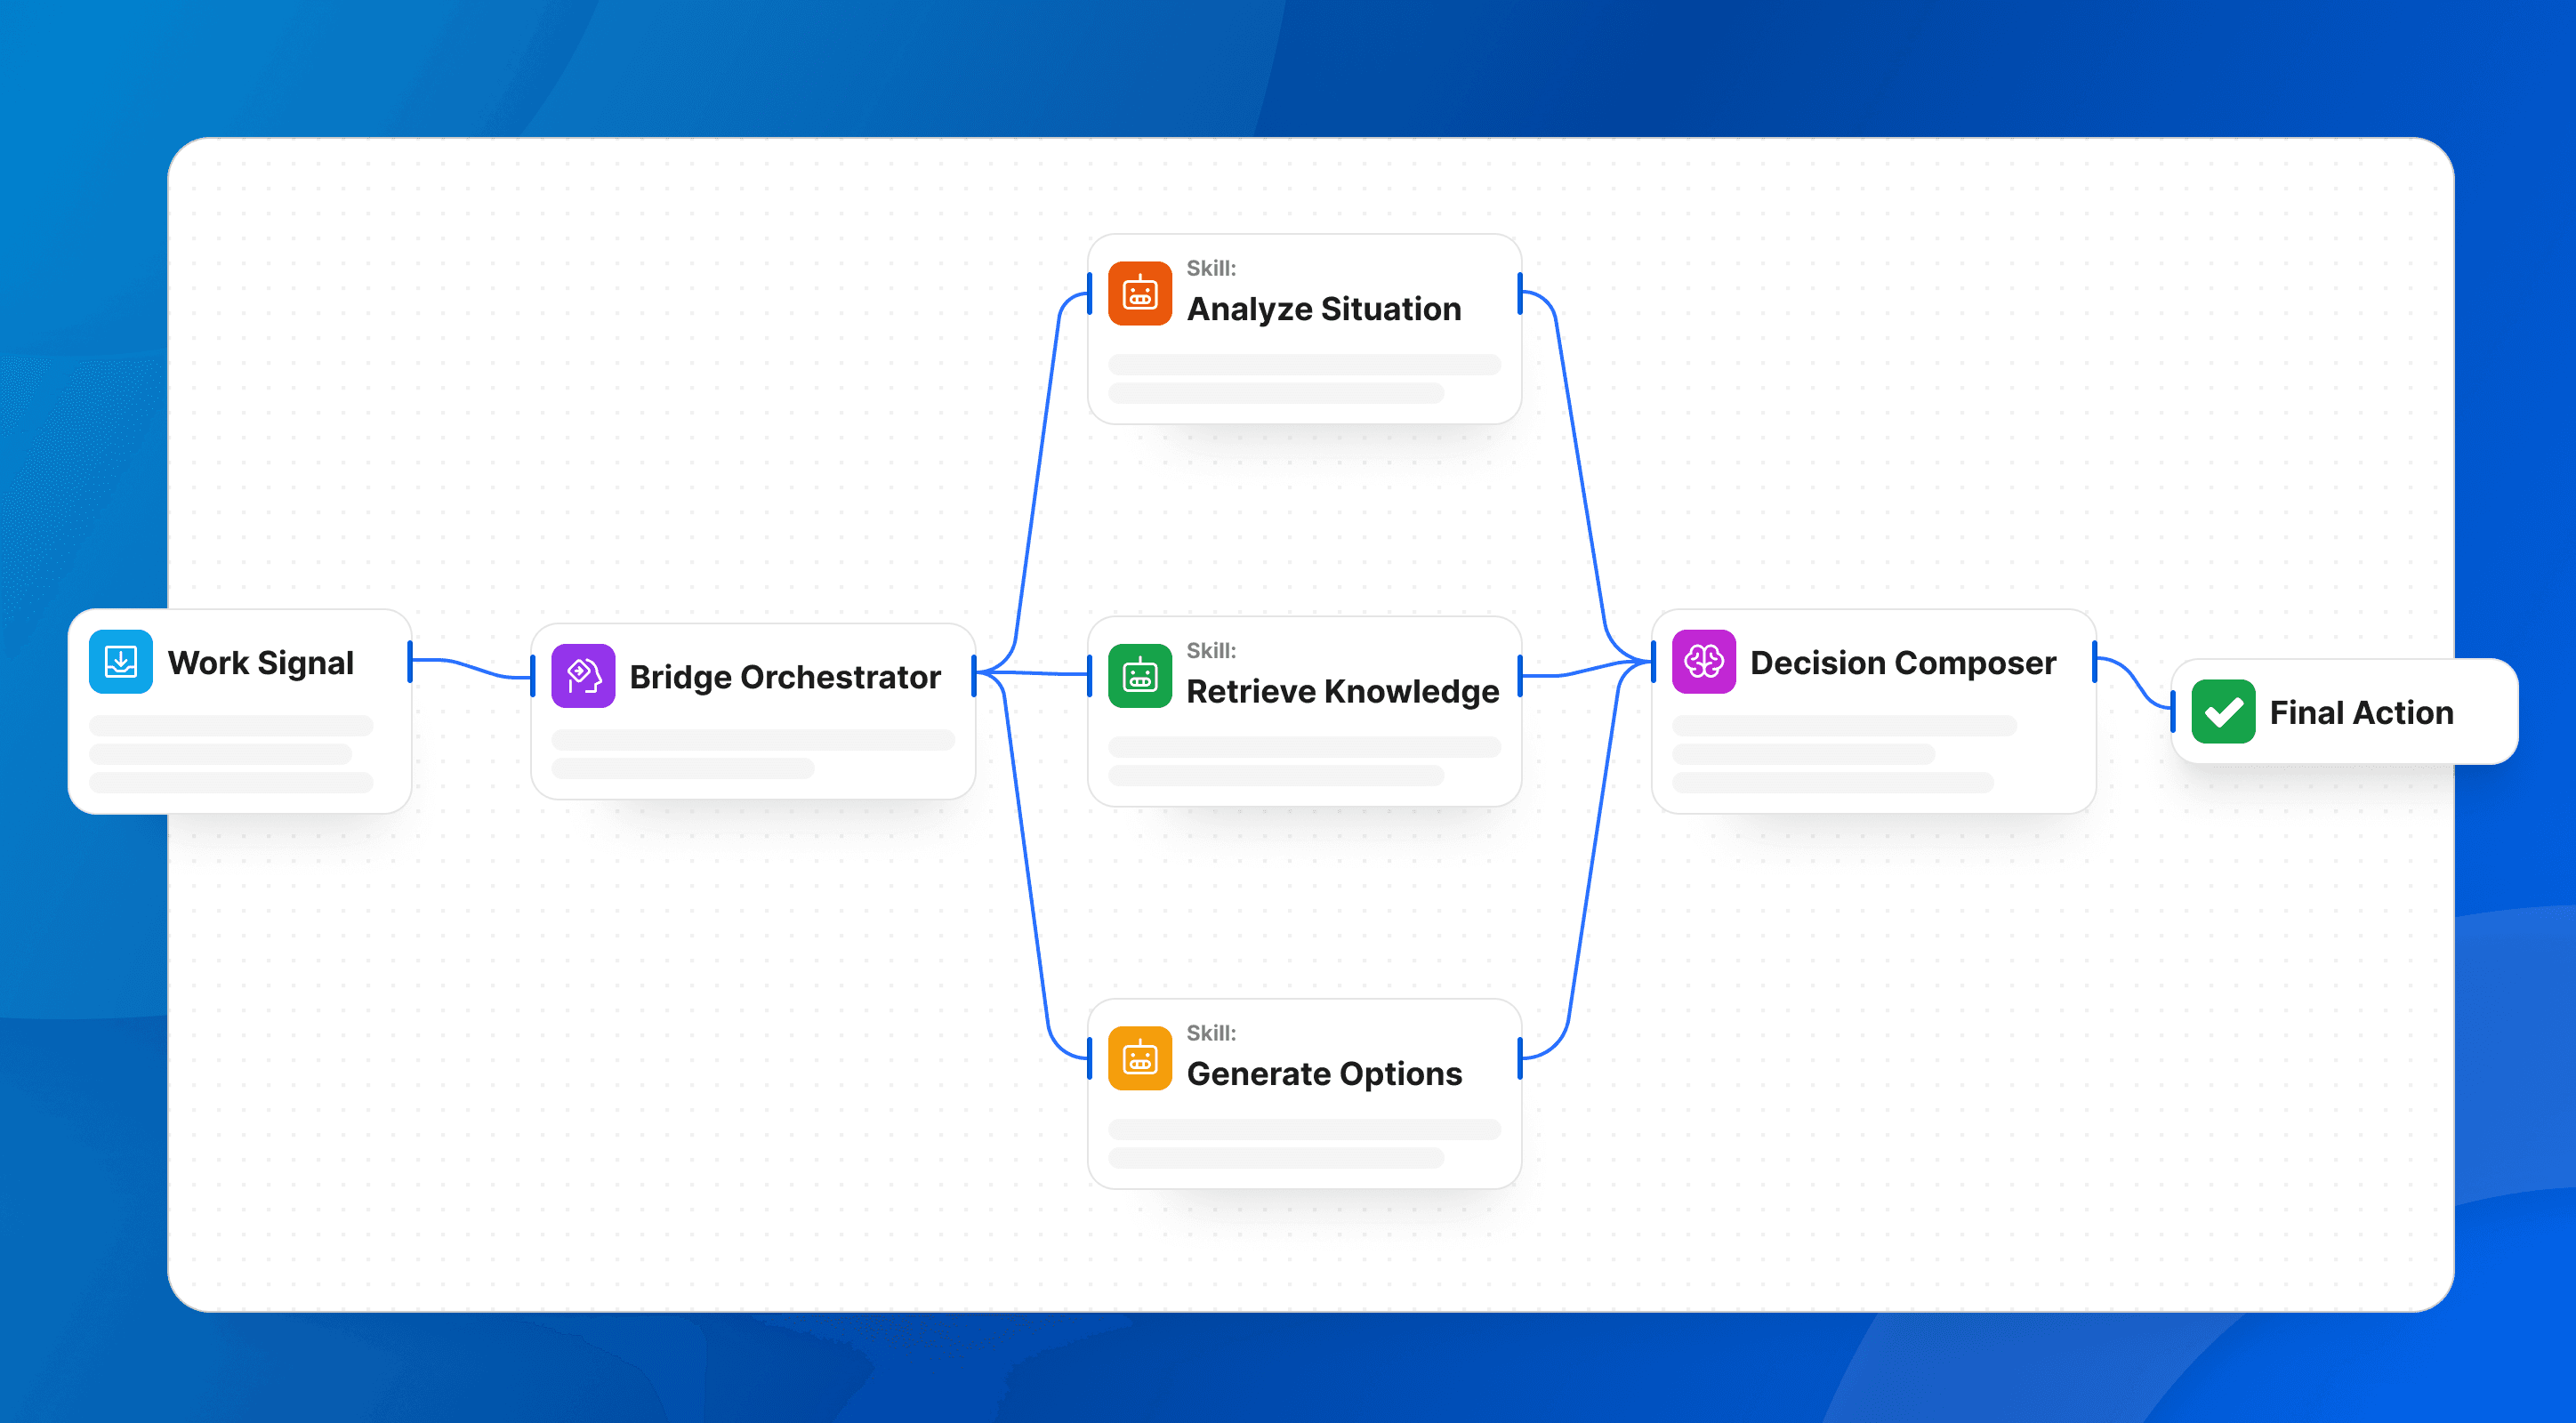
- Pipeline de automação de desenvolvimento: Uma tarefa chega ("adicionar funcionalidade X"). O orquestrador usa um agente de planejamento para projetar a abordagem, um agente de código para implementar, um agente revisor de código para avaliar e, em seguida, integra-se com o repositório de código e o pipeline de CI. Os LLMs alimentam o raciocínio de cada agente; o orquestrador impulsiona o fluxo, as dependências e as transições de estado.
Tentar empurrar as responsabilidades de orquestração para a engenharia de prompts pura rapidamente se torna o que as equipes experientes chamam de "espaguete de prompt" - cadeias frágeis de instruções que quebram imprevisivelmente à medida que a complexidade cresce.
6. Orquestração de LLMs na Prática: Tarefas que o Orquestrador Lida
Aqui está o que uma boa orquestração de LLM realmente faz em uma pilha real - uma lista de verificação concisa das responsabilidades gerenciadas pela orquestração:
Encadeamento de prompts e chamadas de LLM multi-etapas:
- Conectar múltiplas chamadas de LLM preservando o contexto e os resultados intermediários. A saída de um modelo torna-se a entrada de outro, com modelos de prompt e exemplos few-shot gerenciados pelo orquestrador.
- Lidar com a lógica de ramificação: se a primeira chamada classifica uma solicitação como "faturamento", encaminhar para prompts específicos de faturamento; se "técnica", encaminhar para uma cadeia diferente.
Integração de LLMs entre provedores:
- Interfaces padrão para múltiplos provedores e modelos de LLM (OpenAI, Anthropic, Mistral, modelos locais). Uma interface unificada significa que a troca ou adição de provedores não exige a reescrita da lógica da aplicação.
- Suportar múltiplas instâncias de LLM simultaneamente para testes A/B ou processamento paralelo de requisições concorrentes.
Gerenciamento de dados e geração aumentada por recuperação:
- Buscar e preparar o contexto via RAG - consultando bancos de dados vetoriais e armazenamentos de documentos, depois limpando e estruturando os payloads antes que eles cheguem ao modelo.
- Pré-processamento de dados: filtragem, divisão em blocos (chunking) e reordenação de documentos recuperados para que o LLM receba apenas dados contextuais relevantes.
Roteamento inteligente:
- Enviar tarefas simples para modelos mais baratos e rápidos e tarefas de raciocínio complexas para modelos de ponta - otimizando a utilização de recursos e controlando custos.
- Failover automático quando um provedor está inoperante ou com limite de taxa atingido, com disjuntores e balanceamento de carga.
Gerenciamento de memória:
- O orquestrador gerencia o histórico de conversas além da janela de contexto do modelo, compactando ou resumindo turnos mais antigos.
- Memória de longo prazo externalizada para agentes de IA entre sessões - para que um agente "lembre" interações passadas sem colocar tudo no prompt.
Estruturas de orquestração de LLM como LangChain ou LlamaIndex oferecem blocos de construção para essas tarefas. Plataformas como BridgeApp encapsulam capacidades semelhantes em um motor opinativo - lidando com orquestração, roteamento de modelo e governança em um sistema unificado, em vez de exigir que as equipes montem as peças.
7. LLM vs. Orquestrador em Configurações Multiagente e Agente de IA
Sistemas multiagente são um dos padrões definidores da arquitetura de IA de 2025–2026. Em vez de um único prompt monolítico, diferentes agentes baseados em papéis - pesquisador, codificador, revisor, planejador - colaboram em tarefas complexas. É aqui que a diferença entre LLM e orquestrador se torna mais visível.
Como os papéis se dividem em configurações multiagente:
- Cada agente de IA é tipicamente alimentado por um ou mais LLMs (o núcleo de raciocínio). A "inteligência" do agente vem do modelo de linguagem.
- O orquestrador coordena os agentes: atribuição de tarefas, ordenação de dependências, tempos limite, resolução de conflitos e memória compartilhada. A "confiabilidade" do agente vem da orquestração.
Um pipeline de agente típico se parece com isto:
Agente de pesquisa → agente de planejamento → agente de execução → agente de QA, todos coordenados por uma camada de orquestração que gerencia as entregas, rastreia o estado e aplica regras.
Por que a orquestração é crítica para múltiplos agentes de IA:
- Prevenir impasses - agentes esperando uns pelos outros em dependências circulares.
- Impor limites de orçamento, uso de tokens e tempo. Sem isso, os loops de agentes podem consumir recursos infinitamente.
- Manter uma fonte compartilhada de verdade para contexto e memória, para que os agentes não se contradigam ou repitam trabalho.
- Lidar com execução paralela onde seguro, e serializar onde a ordem importa.
Magic Coder da BridgeApp usa exatamente este padrão: um pipeline multiagente com agentes Líder de Equipe, Arquiteto de Sistema, Desenvolvedor, Revisor de Código e QA - todos gerenciados por um motor de orquestração. O pipeline impõe loops de revisão (revisão de plano, revisão de código local) e para em "Aguardando Fusão" por design, para que humanos aprovem as mudanças finais. Os LLMs fazem o raciocínio; o orquestrador garante que o processo seja controlado e mantenível.
8. Orquestração de LLMs para Dados e Contexto: RAG, Memória e "Verdade"
Grandes modelos de linguagem não "conhecem" inerentemente seus dados privados, nem mantêm memória de longo prazo entre chamadas. Cada chamada começa do zero, a menos que algo externo forneça continuidade. É aqui que a recuperação de dados e o gerenciamento de contexto se tornam preocupações centrais da orquestração.
Geração Aumentada por Recuperação (RAG) é o padrão dominante para fundamentar as respostas de LLM em dados reais. O orquestrador consulta fontes de conhecimento - um banco de dados vetorial, armazenamento SQL ou API - recupera documentos relevantes e os injeta no prompt antes que o LLM gere uma resposta. O modelo em si não "pesquisa"; a camada de orquestração lida com pesquisa na web, consultas a bancos de dados e pré-processamento de dados.
Como o orquestrador gerencia o contexto para aplicações de LLM aumentadas por contexto:
- Selecionar quais documentos ou fatos incluir com base na pontuação de relevância e controle de acesso.
- Comprimir e resumir o histórico para se adequar aos limites de tokens - para que o modelo obtenha o sinal máximo com o mínimo de tokens.
- Aplicar reordenação ou filtros para manter o contexto no tópico e prevenir alucinações de dados irrelevantes.
Verificação de saída como responsabilidade da orquestração:
- Verificar as respostas do LLM em relação a bases de conhecimento antes de entregá-las aos usuários.
- Executar um modelo "crítico" ou avaliador separado para saídas arriscadas - um padrão onde o orquestrador chama um segundo modelo de LLM especificamente para controle de qualidade.
Nada disso é algo que o LLM faz por conta própria. Gerenciamento de dados, engenharia de contexto e verificação de fatos são tarefas de orquestração - partes fundamentais da construção de aplicações de LLM sofisticadas em que os usuários podem confiar.
9. Confiabilidade, Segurança e Governança: Por Que a Orquestração É Essencial
Chamadas brutas de LLM não podem resolver várias preocupações de confiabilidade por si mesmas:
- Interrupções de provedores, limites de taxa e erros de rede transitórios são fatos da vida ao trabalhar com endpoints de API de LLM externos.
- Saídas não determinísticas de LLM levam a um comportamento inconsistente entre execuções - o mesmo prompt pode produzir resultados diferentes.
Como o orquestrador aborda a confiabilidade:
- Novas tentativas com backoff, disjuntores e enfileiramento garantem que um único problema do provedor não trave o fluxo de trabalho.
- Cache semântico e idempotência para fluxos de trabalho de longa duração previnem trabalho duplicado e reduzem custos.
- Monitoramento de desempenho e rastreamento de desempenho entre provedores, com métricas chave como latência, taxas de erro e métricas de desempenho para economia de tokens.
Segurança e governança empresarial:
- Políticas centrais para quais modelos e ferramentas podem acessar quais dados. A orquestração gerencia permissões de ferramentas em um nível granular.
- Logs de auditoria de prompts, respostas de LLM e chamadas de ferramentas para conformidade - essencial em indústrias regulamentadas como finanças e saúde.
- Ambientes de execução isolados (sandboxed) que isolam o código impulsionado por LLMs da infraestrutura de produção.
É aqui que plataformas de orquestração sérias diferem de "apenas chamar a API". O BridgeApp, por exemplo, executa automações impulsionadas por LLMs dentro de sandboxes de microVM isolados, aplica regras de permissão em camadas a cada ferramenta que um agente pode acessar e registra cada etapa para revisão humana. Segredos são criptografados em repouso, credenciais Git são de curta duração e escopo limitado, e cada mutação de autenticação é auditada - o tipo de governança que interações brutas de modelos simplesmente não podem fornecer.
10. Como o BridgeApp Usa a Orquestração para Transformar LLMs em Automação de Desenvolvimento Real
Para ancorar esses conceitos em uma plataforma de aplicações impulsionadas por LLM do mundo real, considere como o BridgeApp e o Magic Coder da BridgeApp implementam a arquitetura LLM + orquestrador para o ciclo de vida do desenvolvimento de software (SDLC).
O pipeline de desenvolvimento multiagente dentro do BridgeApp:
- Agente Líder de Equipe - entrada, triagem e orquestração de tarefas; atribui trabalho e aprova planos.
- Agente Arquiteto de Sistema - inspeciona código e requisitos; elabora o plano de implementação.
- Agentes Desenvolvedores (backend / UI) - implementam planos aprovados, escrevem testes e documentação, abrem PRs.
- Agentes Revisor de Código e QA - avaliam o código em relação ao plano, detectam problemas antes da fusão.
O que o motor de orquestração lida:
- Transições de estado: A Fazer → Planejamento → Revisão de Plano → Execução → Revisão de Código Local → Aguardando Fusão. Cada estado tem condições claras de entrada/saída, e os agentes nunca avançam uma tarefa para Concluído - o pipeline para em "Aguardando Fusão" para que humanos revisem a saída final.
- Paralelizar o trabalho entre múltiplos agentes de IA onde seguro, e retomar do último checkpoint após falhas.
Conectando a conceitos anteriores:
- Roteamento inteligente entre diferentes provedores de LLM via uma camada de modelo unificada (OpenAI, Anthropic, DeepSeek e outros) - o orquestrador escolhe o modelo certo para a tarefa de cada agente.
- Gerenciamento de dados usando bases de conhecimento e gráficos de base de código (análise global de código de chamadores, cadeias de chamadas, rastros entre serviços) para fornecer a cada agente os dados contextuais corretos.
- Governança com habilidades explícitas, regras e execução em sandbox - cada agente opera dentro de limites definidos.
O objetivo aqui não é um discurso de vendas. É mostrar que a distinção abstrata entre LLM e orquestrador se mapeia diretamente para como sistemas reais são construídos: os modelos raciocinam, e o orquestrador garante que esse raciocínio ocorra de forma confiável dentro de um pipeline controlado e auditável.
11. Quando Você Precisa de um Orquestrador vs. "Apenas um LLM"?
Nem todo caso de uso de IA precisa de uma plataforma de orquestração completa. Veja onde uma única chamada de API de LLM é suficiente:
- Geração de conteúdo pontual - redigir uma postagem de blog, resumir um documento.
- Perguntas e respostas simples sobre conhecimento público da web - sem dados privados, sem lógica multi-etapas.
- Protótipos ou experimentos internos onde a velocidade importa mais que a confiabilidade.
Contraste isso com situações onde a orquestração de IA se torna inegociável:
- Múltiplos modelos, provedores ou regiões com requisitos de otimização de custos.
- Fluxos de trabalho de LLM multi-etapas com ferramentas, bancos de dados e sistemas externos.
- Necessidade de observabilidade, SLAs e governança em toda a equipe - rastreamento de desempenho, trilhas de auditoria, controles de custos.
- Cenários envolvendo múltiplos agentes de IA que coordenam tarefas complexas.
Uma lista de verificação de decisão simples para líderes de engenharia:
- Você precisa chamar mais de uma ferramenta ou modelo? → Considere a orquestração.
- Você precisa de logs de auditoria, rastreamento de custos e roteamento de modelos? → Você precisa de um orquestrador.
- Equipes não-técnicas dependerão deste sistema de IA para processos de negócios centrais? → Invista em orquestração cedo.
Um artigo de pesquisa de 2026 avaliando a orquestração de LLMs descobriu que a orquestração melhorou a precisão em aproximadamente 4–5 pontos percentuais sobre as baselines de cadeia de pensamento otimizadas, mas veio com aproximadamente 2–4 vezes o custo de token. O trade-off é real, e vale a pena fazê-lo deliberadamente em vez de descobri-lo depois que seu protótipo entra em produção.
Se você está construindo um sistema que importa, pense em "LLM + orquestrador" desde o início, em vez de adicionar a orquestração depois que as coisas quebram.
12. Resumo: LLMs, Orquestradores e o Futuro das Aplicações de IA
- LLMs são os motores de raciocínio e geração - eles produzem a inteligência.
- Orquestradores são as camadas de execução, roteamento e governança - eles produzem a confiabilidade.
- Sistemas de IA escaláveis e agentes de IA exigem que ambos trabalhem juntos, cada um lidando com o que faz de melhor.
A orquestração de LLMs é agora tão fundamental quanto o próprio modelo para a IA de produção. Nas arquiteturas multi-modelo e multiagente de 2025–2026, a camada de orquestração é o que separa uma demonstração de um produto. Plataformas como o BridgeApp combinam integração de LLM, orquestração e automação de desenvolvimento melhores práticas para que as equipes possam ir além de protótipos para pipelines SDLC confiáveis alimentados por IA - com capacidades de equipe que escalam à medida que a organização cresce.
Analise cuidadosamente sua arquitetura atual. Onde as chamadas brutas de LLM estão fazendo "trabalho de orquestração oculto" enterrado em código ou prompts? Onde uma camada de orquestração dedicada - seja por frameworks de orquestração de código aberto, uma plataforma de orquestração gerenciada ou um motor construído para esse fim - poderia simplificar, fortalecer e tornar seu sistema observável? Essa é a pergunta certa sobre framework de orquestração de LLM a ser feita.
FAQ
Aqui estão perguntas frequentes adicionais que vão além do que é coberto no artigo principal.
Equipes pequenas realmente precisam de um orquestrador de LLM, ou é apenas para grandes empresas?
Protótipos muito pequenos e de baixo risco podem depender de chamadas diretas de LLM sem uma camada de orquestração separada. Mas no momento em que uma equipe executa múltiplos casos de uso, trabalha com mais de um modelo ou provedor, ou implanta em um ambiente onde a confiabilidade importa, um orquestrador economiza um tempo significativo de engenharia e reduz o risco operacional. Muitos frameworks de orquestração de LLM - incluindo opções de código aberto - são leves o suficiente para startups. O BridgeApp visa especificamente equipes de engenharia que desejam automação de nível de produção sem construir seu próprio motor de orquestração do zero, tornando-o acessível bem abaixo do nível empresarial.
Qual a diferença entre um orquestrador de LLM e um gateway de IA ou proxy de API?
Um gateway de IA foca no acesso unificado, faturamento, limitação de taxa e roteamento básico entre provedores de LLM - essencialmente gerenciamento de tráfego para interações de modelos. Um orquestrador adiciona lógica de fluxo de trabalho, coordenação de ferramentas, gerenciamento de contexto, encadeamento de prompts e avaliação além do roteamento bruto. Algumas plataformas modernas combinam ambos os papéis em um sistema unificado, mas conceitualmente o orquestrador lida com lógica de aplicação de nível superior e gerenciamento de recursos de LLM, não apenas proxy de requisições.
Um orquestrador pode gerenciar modelos de linguagem de código fechado e de código aberto?
Sim. A maioria das camadas de orquestração modernas são projetadas para trabalhar com backends de modelos heterogêneos: APIs hospedadas (OpenAI, Anthropic, Google) e modelos de código aberto auto-hospedados ou hospedados na nuvem (Llama, Mixtral e outros). A camada de modelo do BridgeApp segue este padrão, abstraindo múltiplos provedores para que a lógica de orquestração, fluxos e regras de governança não dependam de um único fornecedor - permitindo uma verdadeira otimização de custos em todo o cenário de modelos.
A chamada de função dentro de um LLM não é suficiente? Por que ainda preciso de orquestração?
A chamada de ferramenta ou função integrada permite que um modelo decida quando invocar ferramentas específicas durante uma única rodada de conversação, mas não substitui o gerenciamento de estado entre requisições, novas tentativas, agendamento ou coordenação multiagente. Também não lida com políticas de governança em toda a organização. Orquestração e chamada de função são complementares: o orquestrador define a caixa de ferramentas, estabelece as regras e controla o ambiente, enquanto o LLM decide taticamente qual ferramenta usar dentro desses limites.
Como a orquestração do BridgeApp difere das ferramentas genéricas de automação de fluxo de trabalho?
Ferramentas genéricas de fluxo de trabalho orquestram APIs e tarefas humanas, mas não são conscientes da arquitetura para bases de código, pipelines de IA multiagente ou gerenciamento de tokens e custos. O motor de orquestração do BridgeApp é construído especificamente para pipelines de desenvolvimento autônomos: ele entende repositórios através de inteligência de base de código (análise global de código), usa uma camada de modelo LLM para roteamento inteligente entre provedores, aplica governança rigorosa e execução em sandbox, e gerencia a memória do agente entre sessões - capacidades que plataformas genéricas de fluxo de trabalho simplesmente não oferecem.